¿Cuánto trabajo hay detrás de un diagrama PRISMA? Quienes participamos en equipos de revisiones sistemáticas sabemos que bastante más del que parece.
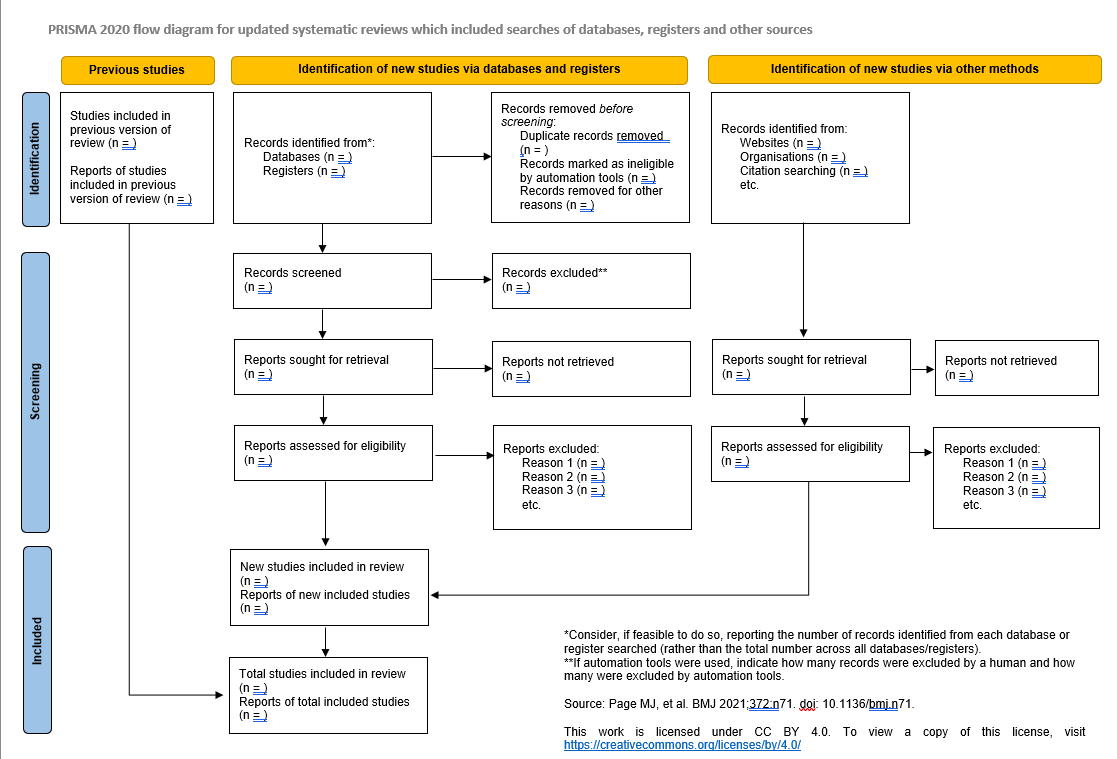
El diagrama de flujo PRISMA 2020 resume el proceso de identificación y selección de estudios: registros recuperados, duplicados eliminados, referencias cribadas, informes evaluados a texto completo, exclusiones y estudios finalmente incluidos.
Todo parece muy ordenado cuando vemos el diagrama terminado. Sin embargo, conseguir que todas las cifras cuadren y, sobre todo, poder explicar de dónde procede cada una de ellas puede convertirse en una de las tareas más laboriosas de una revisión sistemática.
¿Qué nos muestra realmente un diagrama PRISMA 2020?
PRISMA 2020 (Preferred Reporting Items for Systematic Reviews and Meta-Analyses) es una guía para mejorar la transparencia y la integridad de la información publicada sobre las revisiones sistemáticas [1].
Su diagrama de flujo documenta el recorrido de los registros bibliográficos desde su identificación hasta la inclusión de los estudios en la revisión.
El diagrama que acompaña esta entrada corresponde a una actualización de una revisión sistemática e incluye tres vías: los estudios de la versión anterior, los nuevos registros identificados mediante búsquedas en bases de datos y registros de estudios, y los localizados mediante otros métodos, como la búsqueda de citas hacia atrás y hacia delante (backward/forward citation searching).
Las tres vías confluyen en el conjunto de estudios incluidos en la versión actualizada de la revisión.
Figura 1. Diagrama de flujo PRISMA 2020 para actualizaciones de revisiones sistemáticas: estudios previos, identificación de nuevos registros mediante bases de datos y otras fuentes, cribado, evaluación de elegibilidad e inclusión final. Plantilla sin cumplimentar. Fuente: Page et al. [1]. Licencia Creative Commons CC BY 4.0
la búsqueda de citas hacia atrás y hacia delante (backward/forward citation searching) merece especial atención. La búsqueda bibliográfica no termina cuando ejecutamos las estrategias en las bases de datos. Las búsquedas complementarias pueden identificar nuevos estudios, pero también generan referencias duplicadas, publicaciones adicionales de estudios ya conocidos y nuevos informes que deben evaluarse.
Además, PRISMA distingue entre registros (records), informes (reports) y estudios (studies). No son equivalentes: un mismo estudio puede tener varios artículos, resúmenes de congresos o registros de ensayos clínicos asociados.
Esta distinción, aparentemente sencilla, resulta fundamental cuando llega el momento de completar el diagrama.
Lo complicado es conseguir que las cifras cuadren
Durante una revisión sistemática se incorporan nuevas búsquedas, se eliminan duplicados, se recuperan textos completos y se resuelven discrepancias entre revisores.
También pueden cambiar decisiones iniciales de inclusión o exclusión después de revisar un artículo, recibir información de sus autores o discutir un caso con el equipo.
Todo esto debe reflejarse correctamente en los recuentos.
El problema aparece cuando, al preparar el diagrama final, intentamos reconstruir qué ocurrió meses atrás. ¿Cuántos registros procedían realmente de cada búsqueda? ¿Qué duplicados se eliminaron? ¿Por qué se excluyó determinado informe? ¿Se modificó posteriormente alguna decisión? ¿Una publicación corresponde a un estudio nuevo o a otro ya incluido?
Si no hemos conservado esta información, puede resultar muy difícil responder.
Y en las actualizaciones de revisiones sistemáticas, la situación se complica todavía más, porque debemos integrar los estudios previos con los nuevos resultados sin duplicar informes ni estudios.
La importancia de guardar todas las decisiones del equipo
Este es uno de los aspectos que considero más importantes en nuestro trabajo como bibliotecarios especializados en ciencias de la salud.
No basta con conservar las estrategias de búsqueda y los archivos de referencias. También necesitamos mantener un registro de las decisiones que se van tomando durante la revisión, especialmente cuando afectan a la selección de estudios y a las cifras del diagrama PRISMA.
¿Qué información deberíamos conservar?
Las búsquedas realizadas: fuentes consultadas, estrategias, fechas, resultados obtenidos y sucesivas actualizaciones.
La gestión de referencias: archivos originales, procedimientos de deduplicación y número de registros eliminados.
Las decisiones de selección: inclusiones, exclusiones, discrepancias entre revisores y resoluciones finales.
Los motivos de exclusión a texto completo: con criterios claros y aplicados de forma consistente.
Los cambios acordados por el equipo: modificaciones de criterios, reclasificaciones de estudios, correcciones de errores y cualquier decisión que altere los recuentos.
Especialmente importante es conservar las decisiones que se toman en reuniones, intercambios de correos electrónicos o conversaciones entre los revisores. Una decisión puede estar perfectamente justificada, pero si no queda documentada, será difícil reconstruirla posteriormente.
En mi opinión, los bibliotecarios que participamos en revisiones sistemáticas debemos prestar especial atención a esta documentación y contribuir a mantener un registro organizado y actualizado de las decisiones del equipo, con responsabilidades acordadas desde el inicio.
Un diagrama PRISMA no debería construirse al final intentando reconstruir el proceso. Debería ser el resultado de un seguimiento documental mantenido desde el inicio.
Las plataformas de cribado, los gestores bibliográficos y las hojas de seguimiento pueden ayudarnos, pero lo importante es que exista un procedimiento claro y compartido.
Hay que conservar la información necesaria para saber qué se decidió, cuándo, por quién y por qué, así como sus consecuencias sobre la selección de estudios.
Trazabilidad y transparencia: algo más que cumplir PRISMA
PRISMA 2020 establece qué información debe comunicarse sobre el proceso de identificación y selección de estudios [1]. Por su parte, PRISMA-S proporciona recomendaciones específicas para documentar las búsquedas bibliográficas [2].
Pero cumplir estas recomendaciones exige haber registrado adecuadamente el trabajo realizado.
La trazabilidad nos permite reconstruir el recorrido de cada referencia y justificar las decisiones tomadas. La transparencia permite que los lectores conozcan y puedan valorar cómo se llevó a cabo el proceso.
Y ambas dependen de una documentación fiable.
Una revisión sistemática puede prolongarse durante meses, incorporar nuevas búsquedas y reunir a investigadores de distintos centros. En estas circunstancias, confiar en la memoria de los participantes o en archivos dispersos resulta especialmente arriesgado.
Por eso, la participación del bibliotecario especializado no debería terminar con la entrega de los resultados de búsqueda. También podemos contribuir a organizar, documentar y verificar la información necesaria para que el proceso sea coherente y reproducible.
Bibliografía
Page MJ, McKenzie JE, Bossuyt PM, Boutron I, Hoffmann TC, Mulrow CD, et al. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021;372. doi: 10.1136/bmj.n71.
Rethlefsen ML, Kirtley S, Waffenschmidt S, Ayala AP, Moher D, Page MJ, et al. PRISMA-S: an extension to the PRISMA statement for reporting literature searches in systematic reviews. Syst Rev. 2021;10:39. doi: 10.1186/s13643-020-01542-z.
¿Podemos considerar exhaustiva una búsqueda para una revisión sistemática cuando se limita a las grandes bases de datos internacionales?
Esta es la cuestión que plantea Kwok Kei Mak en una reciente carta publicada en Journal of Clinical Epidemiology. Su propuesta resulta especialmente interesante para bibliotecarios y especialistas de información que participan en equipos de revisiones sistemáticas y en un momento en el que los grandes modelos de lenguaje (LLM) y las herramientas de traducción mediante inteligencia artificial pueden reducir algunas de las barreras prácticas que tradicionalmente han dificultado las búsquedas multilingües.
El problema: ¿Son suficientes PubMed o Web of Science?
En muchas revisiones sistemáticas se utilizan prioritariamente grandes índices internacionales como PubMed o Web of Science. Sin embargo, Mak recuerda que existen bases de datos específicas de determinados idiomas o regiones que pueden contener literatura insuficientemente representada en esos recursos.
Entre los ejemplos que menciona se encuentran Airiti y CNKI para literatura china, CiNii y J-STAGE para literatura japonesa y RISS, DBpia y KMBASE para literatura coreana.
La cuestión puede ser particularmente importante cuando existen diferencias transculturales, características poblacionales regionales o métricas diagnósticas locales capaces de influir en los resultados de los estudios. Buscar exclusivamente en bases internacionales podría, en determinadas preguntas, producir una representación geográfica incompleta de la evidencia disponible.
En otras palabras:
Búsqueda exhaustiva ≠ búsqueda exhaustiva únicamente en bases de datos internacionales.
La selección de fuentes debería considerar también la representación lingüística y geográfica pertinente para la pregunta y la población de interés.
¿Qué puede aportar la IA?
Constituir equipos capaces de buscar en múltiples idiomas y manejar bases de datos regionales ha supuesto tradicionalmente una dificultad práctica. Mak considera que los LLM y las herramientas de traducción mediante IA pueden ayudar a los equipos a traducir estrategias de búsqueda y desenvolverse en interfaces de bases de datos específicas de otros idiomas.
Pero esto no significa:
LLM → estrategia traducida → búsqueda
La propuesta incorpora explícitamente la supervisión humana:
Estrategia original → traducción/adaptación mediante LLM → verificación humana → estrategia adaptada a la base regional → búsqueda
Para la adaptación de términos MeSH y palabras clave, Mak propone concretamente una verificación human-in-the-loop.
Por tanto, la IA se plantea como una herramienta para ampliar las posibilidades de la búsqueda, no como sustituta de la competencia profesional necesaria para diseñarla y validarla.
Y aquí el papel del bibliotecario o especialista de información resulta particularmente relevante: traducir palabras no equivale necesariamente a traducir una estrategia de búsqueda. Hay que preservar conceptos, variantes terminológicas, vocabularios controlados, operadores, sintaxis, campos y comportamiento de cada plataforma.
Una propuesta de cambio para PRISMA, PRISMA-S y Cochrane Handbook
La carta va más allá de recomendar que busquemos en otros idiomas. Mak propone introducir cambios explícitos en algunos de los principales marcos metodológicos y de presentación de las revisiones sistemáticas.
Para PRISMA 2020, propone que en los ítems 6 y 7 de Métodos se informe de si se buscaron bases regionales específicas del idioma pertinentes para la pregunta o la población y que, cuando no se hayan utilizado, se justifique su exclusión.
Para PRISMA-S, propone documentar las estrategias de búsqueda utilizadas en idiomas distintos del inglés y los procedimientos de traducción de las consultas asistidos por IA empleados en las plataformas regionales.
Finalmente, para Cochrane Handbook, plantea desarrollar directrices formales para utilizar LLM en la traducción y adaptación de términos MeSH y palabras clave, incorporando obligatoriamente la verificación humana por hablantes nativos o expertos regionales.
Bibliografía
Mak KK. Beyond English: Proposing Standards for Language-Specific Database Integration in Systematic Reviews. J Clin Epidemiol. 2026. doi:10.1016/j.jclinepi.2026.112529.
¿Podemos utilizar inteligencia artificial para buscar bibliografía, redactar un manuscrito o preparar una figura? ¿Hay que declarar siempre su uso? ¿Y qué ocurre con las referencias bibliográficas?
JAMA acaba de publicar una actualización de sus recomendaciones para el uso de inteligencia artificial (IA) por los autores de trabajos científicos. Se puede acceder desde: https://doi.org/10.1001/jama.2026.16613
El documento resulta especialmente útil porque abandona el debate genérico de IA sí o IA no y establece reglas diferentes según para qué se haya utilizado la herramienta.
El principio general es sencillo: la IA puede asistir al investigador, pero exige pasar de la simple declaración de uso a documentar de forma precisa cómo ha intervenido en el trabajo y mantener siempre la verificación y responsabilidad humanas.
¿Qué podemos hacer con IA según JAMA?
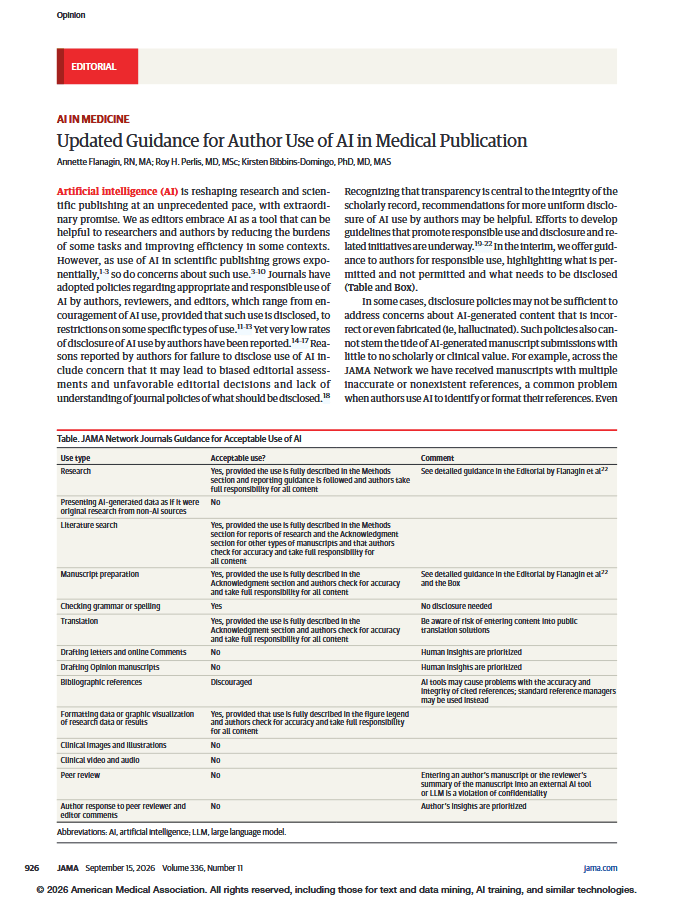
La tabla que acompaña al editorial ofrece una guía bastante práctica:
Uso de IA
Política descrita
IA utilizada como parte de una investigación
Permitida, con descripción completa en Métodos, cumplimiento de las recomendaciones de informe y responsabilidad de los autores.
Presentar datos generados por IA como si procedieran de investigación no basada en IA
No permitido.
Búsqueda bibliográfica
Permitida, pero debe describirse cómo se utilizó la IA y los autores deben verificar la exactitud de los resultados.
Preparación del manuscrito
Permitida con declaración de uso y revisión humana.
Gramática y ortografía
Permitida; no requiere declaración.
Traducción
Permitida, con declaración e indicando la herramienta utilizada y responsabilidad de los autores.
Artículos de opinión, cartas al editor y comentarios
No se permite que la IA los redacte.
Referencias bibliográficas
Desaconsejan el uso de IA para generarlas, formatearlas o gestionarlas; recomiendan gestores bibliográficos convencionales.
Visualización gráfica de datos
Permitida, con declaración en la leyenda.
Imágenes, ilustraciones, vídeo o audio clínicos generados/manipulados mediante IA
No permitidos, salvo cuando formen parte formal del diseño o metodología de investigación.
Revisión por pares
No permitida mediante herramientas externas de IA introduciendo en ella el manuscrito o el informe del revisor, por razones de confidencialidad.
Respuesta de los autores a revisores y editores
No permiten que sea redactada mediante IA.
Especial atención a las referencias bibliográficas
Los editores señalan que han recibido manuscritos con referencias incorrectas o inexistentes y recuerdan que los modelos pueden producir citas aparentemente verosímiles, con autores y títulos plausibles, que en realidad no existen. Por ello recomiendan no confiar en los LLM para generar o gestionar bibliografía y comprobar siempre la integridad, exactitud y existencia de cada referencia.
¿Y las búsquedas bibliográficas con IA?
Este es probablemente uno de los aspectos más interesantes del documento.
JAMA acepta expresamente el uso de IA en búsquedas bibliográficas, siempre que se describa su utilización, se compruebe la exactitud y los autores asuman la responsabilidad sobre los resultados.
Pero esta autorización no significa que una búsqueda realizada exclusivamente mediante ChatGPT u otro LLM sea adecuada para una revisión sistemática. Para revisiones sistemáticas y otras síntesis de evidencia, siguen siendo necesarias normas metodológicas mucho más exigentes. La IA puede utilizarse como herramienta de asistencia, pero delegación sin verificación, no, y transparencia suficiente para comprender qué hizo realmente la herramienta.
Declarar que se utilizó IA no es suficiente
La aportación más práctica del artículo es precisamente lo que entiende JAMA por transparencia.
Frente a frases genéricas como «se utilizó ChatGPT para ayudar en la preparación del manuscrito», documentarqué herramienta se utilizó, cuándo, para qué y sobre qué parte concreta del trabajo mejora considerablemente la transparencia y la trazabilidad.
Cuando corresponda declarar la utilización de IA, deberían indicarse:
Herramienta utilizada + versión + fabricante + fecha de uso + finalidad + partes del manuscrito en las que intervino + confirmación de la responsabilidad de los autores.
JAMA solicita expresamente estos datos en su nueva política.
Bibliografía
Flanagin A, Perlis RH, Bibbins-Domingo K. Updated guidance for author use of AI in medical publication. JAMA. 2026;336(11):926-928. doi:10.1001/jama.2026.16613.
Abordamos uno de los temas más actuales en nuestro campo: la incorporación de herramientas de inteligencia artificial (IA) en la búsqueda y descubrimiento de estudios primarios para revisiones sistemáticas. Analizamos si estas plataformas están listas para sustituir nuestros métodos tradicionales o si debemos enfocarlo desde otra perspectiva.
¿Puede la IA sustituir la búsqueda bibliográfica tradicional?
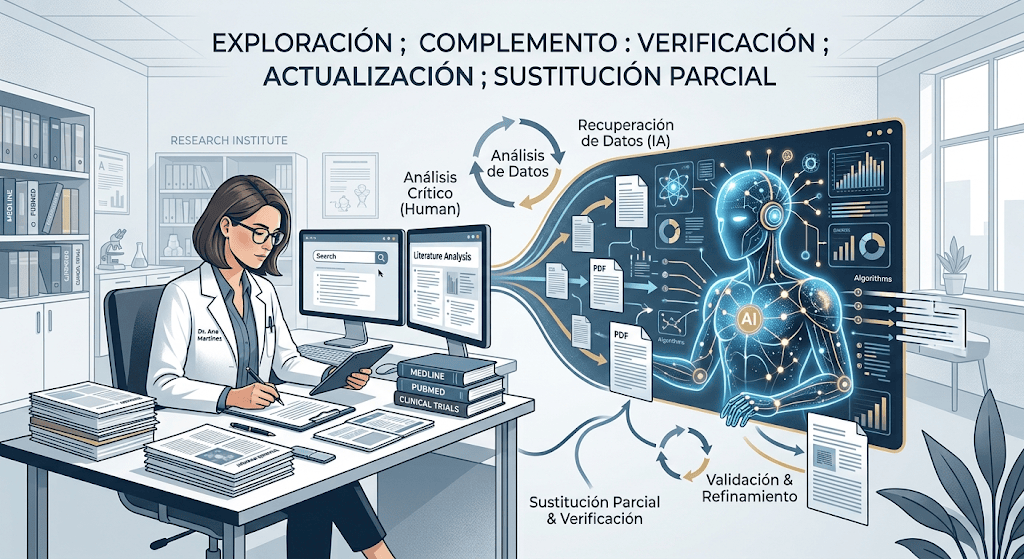
La respuesta corta es: todavía no. La evidencia disponible respalda el uso de herramientas de IA como métodos exploratorios, complementarios y de verificación, pero no respalda su utilización como sustitutos generales de una búsqueda bibliográfica sistemática y multibase diseñada por especialistas de la información.
La principal razón para mantener esta cautela es la evidente pérdida de exhaustividad (recall), unida a problemas de opacidad algorítmica, falta de cobertura adecuada en la literatura gris y graves retos de reproducibilidad (1).
Lo que nos dicen los estudios
El espejismo de la precisión inicial: Las herramientas de inteligencia artificial son eficaces para colocar documentos muy relevantes en los primeros puestos de la página de resultados. Esto resulta útil para exploraciones rápidas, pero genera una falsa seguridad metodológica en el usuario al ocultar todo el volumen de evidencia que el algoritmo ha omitido de forma invisible.
Un estudio del Comité de Metodología de la European Academy of Allergy and Clinical Immunology (EAACI) comprobó que estrategias basadas en IA identificaron el 85,7% de los artículos provistos de DOI, pero su sensibilidad cayó al 56,3% respecto al total de ensayos elegibles. Las plataformas no lograron recuperar literatura gris ni ensayos no publicados de los registros (1).
Al evaluar flujos totalmente automatizados con GPT-4 en revisiones de retinopatía diabética, la IA identificó apenas entre el 6,1% y el 32,7% de los artículos incluidos originalmente (3).
Pérdida crítica de sensibilidad: El pilar de una revisión sistemática es minimizar el sesgo de selección recuperando el universo completo de estudios elegibles. Los tres casos empíricos citados demuestran que las plataformas actuales fracasan en esta tarea, omitiendo proporciones inaceptables de la literatura (desde un 43,7% en el mejor de los casos clínicos hasta más de un 90% en flujos automatizados) (1, 4). En la evaluación del rendimiento de Elicit frente a las búsquedas bibliotecarias originales de cuatro revisiones sistemáticas, la sensibilidad media de la IA fue solo del 37,9%, muy inferior al 93,5% de la búsqueda convencional (2).
Agravamiento del sesgo de publicación: El hallazgo de la EAACI revela una deficiencia algorítmica profunda: la IA depende casi exclusivamente de metadatos estructurados y documentos comerciales con DOI. Al ser incapaz de rastrear literatura gris, resúmenes de congresos o registros de ensayos clínicos no publicados, la IA introduce un sesgo de difusión que alteraría gravemente las estimaciones de cualquier metanálisis en salud (1).
Superioridad de la búsqueda experta: La diferencia entre Elicit (37,9%) y la búsqueda bibliotecaria original (93,5%) confirma que el modelo semántico o generativo no puede sustituir a la arquitectura booleana multibase (2). La combinación de vocabularios controlados (MeSH, Emtree), truncamientos y diseño estructurado sigue siendo el único patrón de referencia válido.
Funciones metodológicas defendibles: El enfoque híbrido
Para integrar la IA de forma metodológicamente defendible, nunca debe aplicarse como una «caja negra» universal.
Función
Objetivo
Uso admisible
Exploración
Comprender conceptos, terminología y estructura del campo.
Antes de cerrar el protocolo o la estrategia.
Complemento
Encontrar estudios no recuperados por coincidencia léxica o por una fuente concreta.
En paralelo o después de la búsqueda convencional.
Verificación
Comprobar si existen lagunas temáticas o referencias clave ausentes.
Tras ejecutar la estrategia principal.
Actualización
Detectar candidatos nuevos o relacionados.
Revisiones vivas o actualización periódica.
Sustitución parcial
Reducir tiempo en revisiones rápidas.
Solo en situaciones excepcionales y con alcance restringido.
Exploración: Muy útil en las etapas iniciales de la estrategia para comprender la terminología y sugerir sinónimos locales. Advertencia: Los términos propuestos pueden ser limitados o carecer de lenguaje controlado (MeSH/Emtree), por lo que siempre deben ser revisados y validados por un bibliotecario o especialista (1, 5-6).
Complemento: Usar la búsqueda semántica y las redes de citas en plataformas de IA (en paralelo o después de la búsqueda convencional) resulta útil para hallar estudios que las cadenas booleanas no logran recuperar por simple coincidencia léxica (1, 7-8).
Verificación: Las herramientas son eficaces para comprobar posibles lagunas temáticas o asegurar la inclusión de referencias clave tras haber ejecutado la estrategia principal (1).
Transparencia y documentación
Dado que un alto número de resultados relevantes puede dar una falsa sensación de seguridad, y considerando que la IA sufre de irreproducibilidad, la transparencia en el reporte es crucial.
Cualquier revisión sistemática que integre estas herramientas debe registrar y auditar el proveedor, la plataforma, la versión o modelo, la fecha exacta, los prompts completos, el criterio de parada y los procesos de exportación. Aunque existen herramientas de apoyo emergentes como la lista de comprobación PRISMA-trAIce (9), es necesario aclarar que dicha lista no es una extensión oficial y no cuenta actualmente con el respaldo ni la validación del grupo PRISMA (10).
Conclusión
La revolución de la IA nos abre puertas increíbles, pero los profesionales de la información bibliotecaria seguimos siendo el eje de una síntesis de evidencia libre de sesgos y opacidad. El camino a seguir es metodológicamente híbrido: mantengamos nuestra búsqueda sistemática y transparente como motor principal e integremos la IA como un potente asistente especializado, bajo estricta supervisión humana, documentación exhaustiva y validación constante.
Bibliografía
Sousa-Pinto B, Bognanni A, Jemioło P, Vieira RJ, Nguyen TH, Munn Z, et al. Use of artificial intelligence-based platforms to support searches in evidence synthesis studies: a study of the EAACI Methodology Committee. Clin Transl Allergy. 2026;16:e70202.
Lau O, Golder S. Comparison of Elicit AI and traditional literature searching in systematic reviews using four case studies [preprint]. medRxiv. 2025. doi:10.1101/2025.06.17.25329772.
Chen HC, et al. Can large language models fully automate or partially assist paper selection in systematic reviews? Br J Ophthalmol. 2025. doi:10.1136/bjo-2024-326254.
Di Febo R, et al. Comparative evaluation of artificial intelligence-assisted literature search tools for identifying clinically meaningful evidence in cardiology. Eur Heart J Digit Health. 2026. doi:10.1093/ehjdh/ztag125.
Spillias S, Tuohy P, Andreotta M, et al. Human-AI collaboration to identify literature for evidence synthesis. Cell Rep Sustain. 2024;1:100132.
Chen X, Feng Y. Exploring the use of generative artificial intelligence in systematic searching: a comparative case study of a human librarian, ChatGPT-4 and ChatGPT-4 Turbo. IFLA J. 2025;51(1):84-93. doi:10.1177/03400352241263532.
van de Schoot R, Messina Coimbra B, Evenhuis T, et al. The hunt for the last relevant paper: blending the best of humans and AI. Eur J Psychotraumatol. 2025;16(1):2546214.
Wätzold F, Popiela B, Mayer J. Methodology for AI-based search strategy of scientific papers: exemplary search for hybrid and battery electric vehicles in the Semantic Scholar database. Publications. 2024;12(4):49. doi:10.3390/publications12040049
Holst D, Moenck K, Koch J, Schmedemann O, Schüppstuhl T. Transparent reporting of AI in systematic literature reviews: development of the PRISMA-trAIce checklist. JMIR AI. 2025;4:e80247. Moher D, Page MJ, McKenzie JE, Takwoingi Y, Mayo-Wilson E. PRISMA-trAIce: a name without endorsement. JMIR AI. 2026;5:e104210.
Flemyng E, Noel-Storr A, Macura B, et al. Position statement on artificial intelligence (AI) use in evidence synthesis across Cochrane, Campbell Collaboration, JBI and Collaboration for Environmental Evidence 2025. Cochrane Database Syst Rev. 2025;(10):ED000178.
JBI acaba de publicar una importante actualización de su metodología para la realización de revisiones de alcance oscoping reviews (1). La nueva versión del capítulo 10 del JBI Manual for Evidence Synthesis consolida en un único documento más de una década de desarrollo metodológico y, especialmente, la abundante orientación publicada desde la última gran actualización de 2020.
No estamos ante un cambio completo de metodología, sino ante su actualización, ampliación y consolidación. Desde 2020, el JBI Scoping Review Methodology Group ha ido dando respuesta a problemas metodológicos que no estaban suficientemente desarrollados en la guía anterior.
¿Qué incorpora la nueva guía?
Entre las novedades más relevantes se encuentra la incorporación de la definición formal descoping review publicada por Munn y colaboradores en 2022: una síntesis de evidencia cuyo objetivo es identificar y mapear sistemáticamente la amplitud de la evidencia disponible sobre un tema, campo, concepto o cuestión (2).
También se refuerza considerablemente la importancia del protocolo previo de la revisión, con recomendaciones específicas para su desarrollo y comunicación. El protocolo se considera un elemento esencial para aumentar el rigor, la transparencia y la reproducibilidad de este tipo de síntesis (3).
La actualización incorpora además orientaciones más detalladas sobre la participación de los usuarios del conocimiento, las cuestiones relacionadas con equidad, diversidad e inclusión, y sobre cómo realizar la extracción, análisis y presentación de los resultados, aspectos sobre los que JBI ha publicado recomendaciones específicas durante los últimos años (4).
Otro cambio especialmente interesante es la incorporación de orientación sobre el uso de software y herramientas de automatización en las distintas fases de una scoping review. La automatización se contempla como apoyo al trabajo de los revisores y no como sustitución indiscriminada de la supervisión metodológica humana (5).
La nueva guía aborda asimismo cuestiones cada vez más frecuentes en la práctica: cómo gestionar scoping reviews de gran tamaño, cómo realizar rapid scoping reviews, qué papel pueden desempeñar estas revisiones en el desarrollo de guías de práctica clínica y en la priorización de la investigación, y cómo pueden contribuir a reducir el desperdicio en investigación.
Mejor delimitación frente a otros tipos de revisión
Un aspecto especialmente útil es el esfuerzo por clarificar las diferencias entre las scoping reviews y otros productos de síntesis que con frecuencia se confunden entre sí, como las mapping reviews, evidence and gap maps y overviews of reviews. La elección del tipo de revisión debe depender de la pregunta y del objetivo de la síntesis, no simplemente de la etiqueta utilizada por los autores.
La actualización también explica la relación entre PRISMA-ScR y PRISMA 2020. Conviene recordar que PRISMA-ScR es fundamentalmente una guía para la comunicación o reporting de una scoping review, mientras que el capítulo de JBI proporciona la orientación metodológica para planificarla y realizarla. PRISMA-ScR, publicado en 2018, contiene 20 ítems esenciales y dos opcionales. [6]
Una actualización que merece ser revisada
Para quienes realizan, asesoran o evalúan revisiones de alcance, esta nueva versión debería convertirse en la referencia metodológica de consulta. Su principal aportación es reunir en un único capítulo orientaciones que hasta ahora se encontraban dispersas en numerosas publicaciones y ampliar la metodología a problemas que han surgido con la creciente utilización de las scoping reviews.
Munn Z, Pollock D, Khalil H, Alexander L, McInerney P, Godfrey CM, et al. What are scoping reviews? Providing a formal definition of scoping reviews as a type of evidence synthesis. JBI Evid Synth. 2022;20(4):950-2. doi:10.11124/JBIES-21-00483.
Peters MDJ, Godfrey C, McInerney P, Khalil H, Larsen P, Marnie C, et al. Best practice guidance and reporting items for the development of scoping review protocols. JBI Evid Synth. 2022;20(4):953-68. doi:10.11124/JBIES-21-00242.
Pollock D, Peters MDJ, Khalil H, McInerney P, Alexander L, Tricco AC, et al. Recommendations for the extraction, analysis, and presentation of results in scoping reviews. JBI Evid Synth. 2023;21(3):520-32. doi:10.11124/JBIES-22-00123.
Khalil H, Pollock D, McInerney P, Evans C, Moraes EB, Godfrey CM, et al. Automation tools to support undertaking scoping reviews. Res Synth Methods. 2024;15(6):839-50. doi:10.1002/jrsm.1731.
Tricco AC, Lillie E, Zarin W, O’Brien KK, Colquhoun H, Levac D, et al. PRISMA Extension for Scoping Reviews (PRISMA-ScR): checklist and explanation. Ann Intern Med. 2018;169(7):467-73. doi:10.7326/M18-0850.
Durante la extracción de datos de una revisión sistemática, es frecuente encontrar publicaciones que no proporcionan toda la información necesaria. Pueden faltar características de la población, detalles de la intervención, resultados numéricos o información imprescindible para evaluar el riesgo de sesgo.
Ante esta situación, surge la duda metodológica: ¿es aceptable contactar con los autores para solicitar estos datos? ¿Puede incorporarse a la revisión la información obtenida mediante correo electrónico?
La respuesta es afirmativa: contactar con los autores aporta información relevante y es metodológicamente válido, siempre que el procedimiento sea sistemático, trazable y transparente.
¿Por qué y cuándo está justificado el contacto?
El contacto no debe realizarse de manera improvisada o selectiva. Una revisión metodológica Cochrane concluyó que se debe intentar obtener información no publicada cuando falten datos clave, aunque el éxito del procedimiento es variable [1].
Motivo del contacto
Ejemplo de aplicación práctica
Aclaración metodológica
Confirmar métodos de aleatorización o cegamiento para evaluar el riesgo de sesgo.
Recuperación de datos
Solicitar resultados numéricos presentados de forma incompleta o medidas de dispersión faltantes.
Verificación de la muestra
Detectar poblaciones duplicadas, solapadas o confirmar características demográficas.
Resolución de discrepancias
Aclarar incoherencias entre el abstract, las tablas y los resultados del artículo.
Tabla 1. Objetivos principales del contacto con investigadores
Esta información no es secundaria. Según Meursinge Reynders et al., el contacto modificó alguna evaluación del riesgo de sesgo en el 48,3% de las revisiones evaluables, alguna valoración GRADE en el 31,4%, algún resultado primario o secundario en el 36,4% y la estimación global del efecto en el 24,6% [2].
La realidad de las respuestas: recibir un correo no equivale a obtener datos
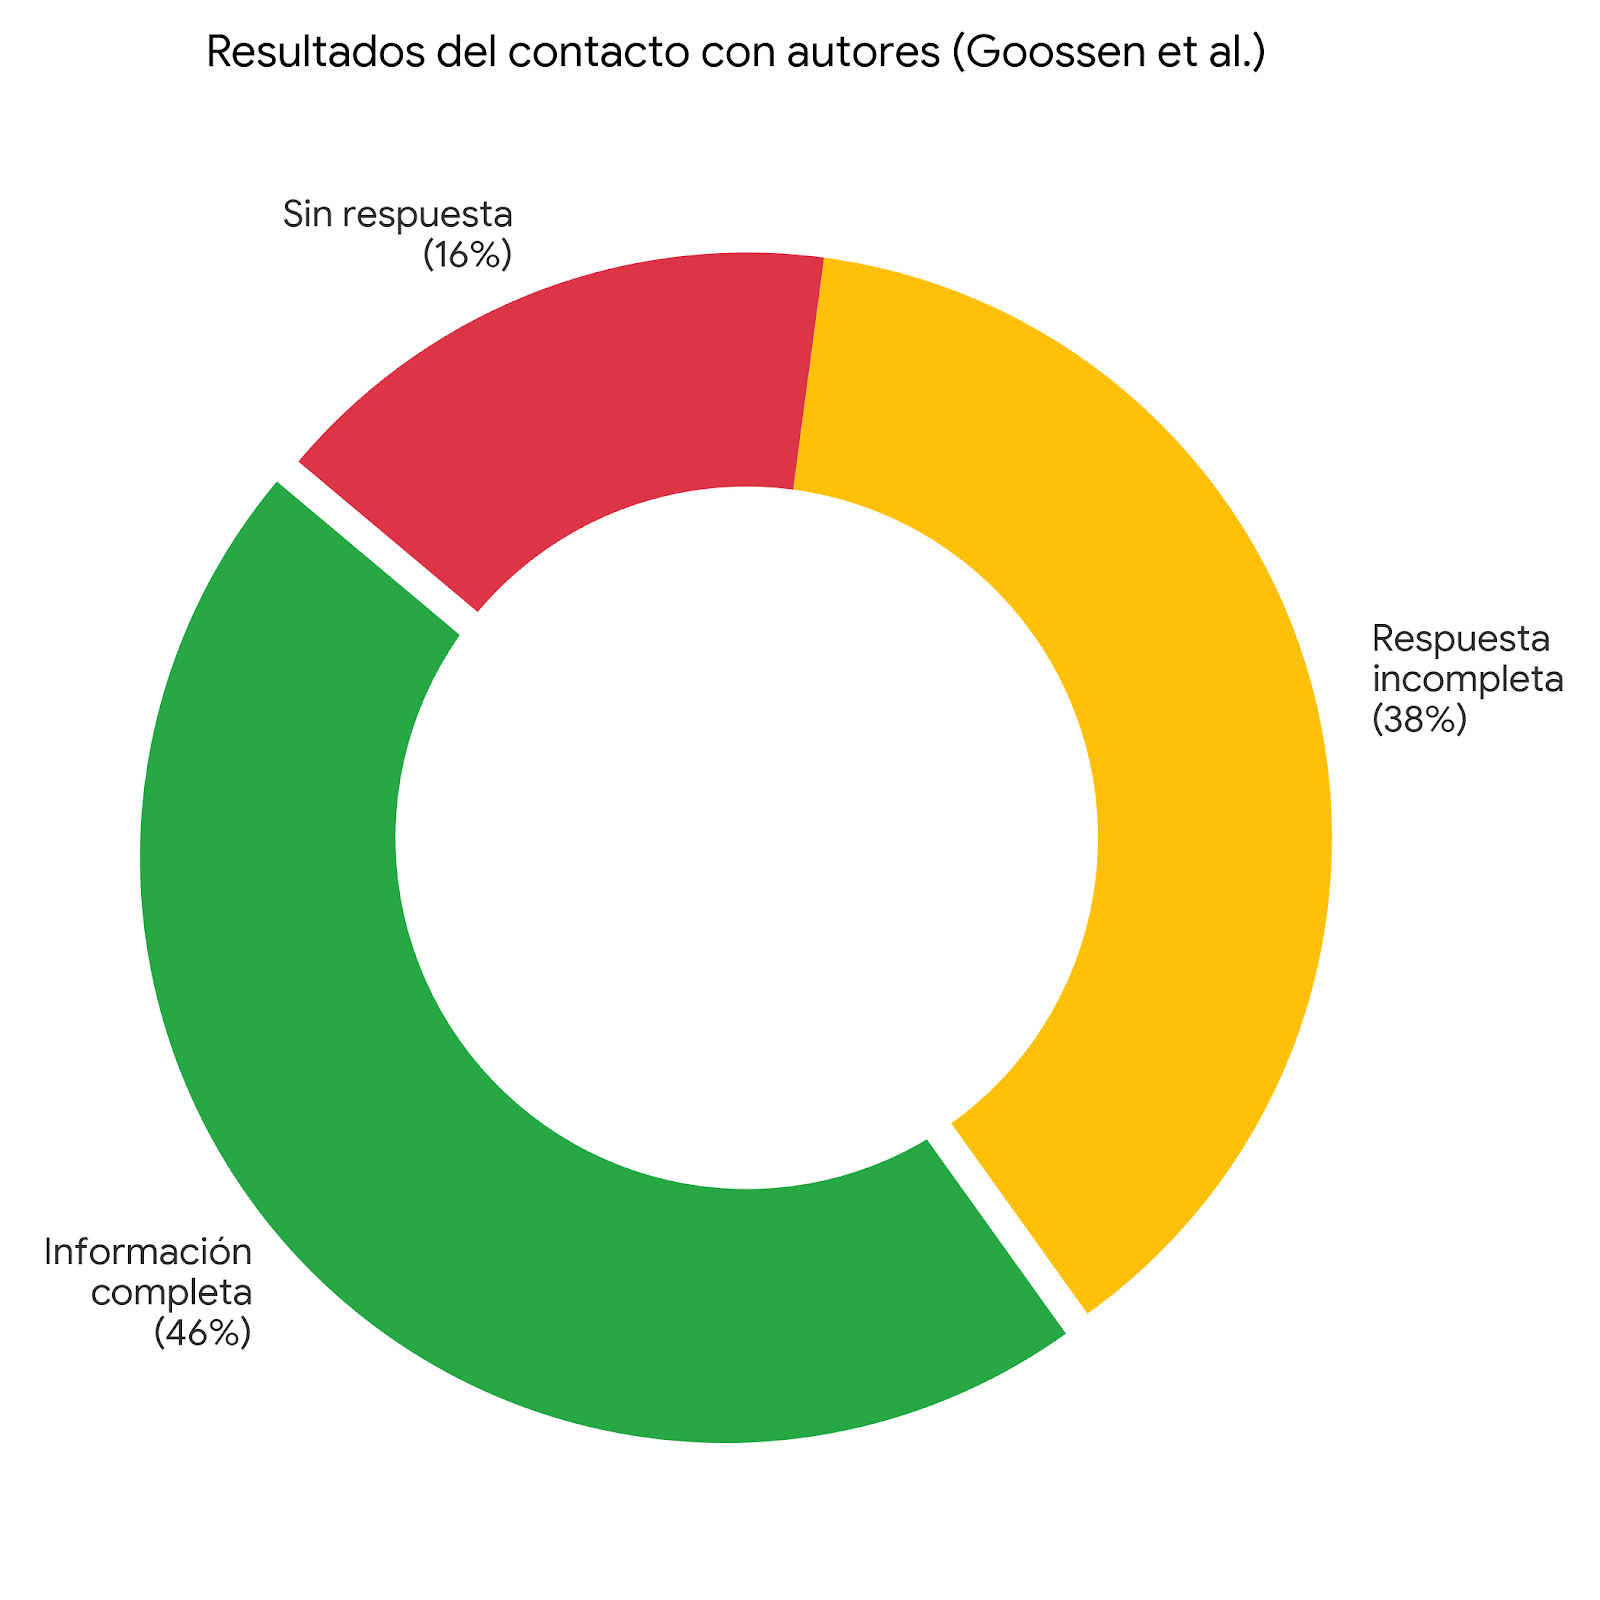
La tasa de respuesta y la recuperación de información útil son conceptos diferentes. En el estudio de Goossen et al., se recibió alguna respuesta en el 84% de los contactos, pero solo se obtuvo toda la información solicitada en el 46% [3].
Figura 1. La tasa de respuesta y la recuperación de información completa son resultados diferentes Gossen (3).
El rendimiento del contacto es mayor al aclarar métodos (52% de éxito) que al recuperar datos cuantitativos (25%) [3]. Las barreras más frecuentes para recuperar datos originales incluyen:
Antigüedad del estudio o pérdida de bases de datos.
Cambio de institución o jubilación de los investigadores.
Restricciones de privacidad institucionales.
Variables que nunca llegaron a recogerse en el diseño original.
Un procedimiento estandarizado en 4 fases
La decisión de contactar con los autores debe constar en el protocolo de la revisión. Si se adopta a posteriori, debe documentarse como modificación metodológica antes de analizar las respuestas.
Fase 1: Preparación del mensaje
El contacto debe dirigirse al autor de correspondencia. La evidencia actual demuestra que incluir preguntas breves, numeradas y específicas directamente en el cuerpo del correo es más efectivo y reduce el tiempo de trabajo de los revisores frente al envío de formularios adjuntos [3].
Fase 2: Estrategia de seguimiento limitada
Los recordatorios son útiles (el 32% de las respuestas llega tras un recordatorio [5]), pero el proceso debe tener un límite definido previamente. Antes de comenzar, deben definirse el intervalo entre contactos, el número máximo de intentos y la fecha de cierre.
Un procedimiento viable podría ser:
Enviar el primer correo al autor de correspondencia.
Esperar 14 días.
Enviar un recordatorio si no se ha recibido respuesta.
Si continúa sin responder, contactar con otro autor activo de la publicación, por ejemplo, el primer autor o el autor sénior.
Enviar un único recordatorio al segundo autor.
Cerrar el proceso en la fecha previamente establecida.
Cuando la dirección publicada ya no funciona, puede buscarse una dirección actualizada en publicaciones recientes, directorios institucionales u otras fuentes profesionales. En el estudio de Goossen et al., el 20% de los artículos no incluía una dirección de correo y el 17% de las direcciones publicadas había dejado de funcionar [3].
Fase 3: Evaluación de la respuesta
Toda respuesta recibida debe analizarse críticamente antes de volcarse en la extracción. Debemos preguntarnos:
¿Responde inequívocamente a la pregunta clínica o metodológica formulada?
¿Puede atribuirse inequívocamente al estudio correspondiente?
¿Es coherente con la publicación original?
Si contradice el artículo publicado, no debe sustituirse silenciosamente. Hay que documentar la discrepancia y pedir confirmación. Es necesario documentar la discrepancia y solicitar confirmación al autor. La verificación también es recomendable cuando la respuesta modifica la elegibilidad del estudio, el resultado extraído o la interpretación de los hallazgos [2].
Fase 4: Registro y transparencia
La procedencia de cada dato debe quedar clara en la matriz de extracción. La falta de respuesta nunca debe interpretarse como ausencia del acontecimiento estudiado; debe constar como «no informada».
Para facilitar la trazabilidad y la redacción del informe final, es fundamental mantener un registro detallado.
ID Estudio
Autor contactado
Fecha intento 1
Fecha de recordatorio
Estado de la respuesta
Procedencia del dato final
Smith 2022
J. Smith (Corresp.)
15/09/2026
29/09/2026
Aclaración completa
No publicado, vía email
Pérez 2018
M. Pérez (Sénior)
10/09/2026
24/09/2026
Datos inaccesibles
No disponible
Chen 2021
L. Chen (Corresp.)
01/09/2026
–
Sin respuesta
No disponible
Tabla 2. Modelo de registro de contactos para la matriz de extracción
Este nivel de transparencia todavía es mejorable. En el estudio de Meursinge Reynders et al., el 73,4% de las revisiones Cochrane examinadas había contactado o intentado contactar con los autores, pero solo el 18,9% informó de manera completa qué información había obtenido de cada estudio que respondió [2].
Limitaciones de la evidencia
La evidencia sobre la forma más eficaz de contactar con los autores es limitada y heterogénea. La revisión metodológica Cochrane identificó únicamente seis estudios comparativos, cinco de ellos publicados solo como resúmenes [1]. Algunos trabajos posteriores proceden de revisiones concretas, utilizan muestras pequeñas o analizan contextos muy específicos [3-6].
Por tanto, no puede afirmarse que exista una estrategia universalmente óptima. Las recomendaciones disponibles permiten diseñar un procedimiento razonable e informado por la evidencia, pero los plazos, el número de recordatorios y los criterios de cierre deben adaptarse a cada revisión y quedar definidos previamente.
En conclusión
Contactar con los autores es un recurso metodológicamente indispensable que puede alterar las conclusiones de una revisión sistemática. Sin embargo, no basta con enviar correos de forma aleatoria; exige un protocolo explícito y documentado.
La regla de oro es sencilla: la información recibida es sumamente útil, pero siempre debe distinguirse del dato publicado y su impacto debe reportarse con total transparencia.
Referencias
Young T, Hopewell S. Methods for obtaining unpublished data. Cochrane Database Syst Rev. 2011;(11). doi:10.1002/14651858.MR000027.pub2.
Meursinge Reynders R, Ladu L, Di Girolamo N. Contacting of authors modified crucial outcomes of systematic reviews but was poorly reported, not systematic, and produced conflicting results. J Clin Epidemiol. 2019;115:64-76. doi:10.1016/j.jclinepi.2019.07.001.
Goossen K, Rombey T, Kugler CM, De Santis KK, Pieper D. Author queries via email text elicited high response and took less reviewer time than data forms: a randomised study within a review. J Clin Epidemiol. 2021;135:1-9. doi:10.1016/j.jclinepi.2021.02.006.
Godolphin PJ, Bath PM, Montgomery AA. Short email with attachment versus long email without attachment when contacting authors to request unpublished data for a systematic review: a nested randomised trial. BMJ Open. 2019;9. doi:10.1136/bmjopen-2018-025273.
Cooper C, Talens Bou J, Varley-Campbell J. Evaluating the effectiveness, efficiency, cost and value of contacting study authors in a systematic review: a case study and worked example. BMC Med Res Methodol. 2019;19:45. doi:10.1186/s12874-019-0685-0.
O’Leary F. Is email a reliable means of contacting authors of previously published papers? A study of the Emergency Medicine Journal for 2001. Emerg Med J. 2003;20:352-3. doi:10.1136/emj.20.4.352.
Las revisiones sistemáticas aspiran a fundamentar las decisiones sanitarias en la mejor evidencia disponible. Sin embargo, muchos de los métodos empleados para realizarlas siguen apoyándose más en la convención que en comparaciones empíricas. Los Studies Within A Review (SWAR) abordan esta contradicción: son estudios integrados en una revisión que evalúan distintas formas de planificarla, realizarla o comunicarla, con el fin de construir una metodología de síntesis de evidencia que también esté basada en evidencia.
Definición y naturaleza de un SWAR
Se define como estudios metodológicos incorporados dentro de una o varias revisiones sistemáticas u otra síntesis de evidencia (1). Su finalidad no es responder a la pregunta clínica de la revisión, sino generar evidencia sobre cómo deben planificarse, realizarse o comunicarse las revisiones. En español podrían denominarse «estudios integrados en una revisión» o «estudios dentro de una revisión».
La idea esencial es que una revisión sistemática en curso se utiliza como revisión anfitriona para investigar una incertidumbre metodológica. Por tanto, en un mismo proyecto coexisten dos niveles de preguntas diferentes:
Tipo de pregunta
Qué responde
Pregunta de la revisión anfitriona (Responde a una incertidumbre clínica o social).
¿Qué dice la evidencia sobre el problema clínico, asistencial o de salud? Ej.: ¿Es efectivo el fármaco A para reducir la mortalidad en la patología B? ¿Es eficaz la rehabilitación pulmonar en pacientes con EPOC?
Pregunta metodológica del SWAR (Responde a una incertidumbre del proceso).
¿Qué método permite realizar una parte de la revisión de forma más válida, eficiente o útil? Ej.: ¿Qué modalidad de cribado de referencias requiere menos tiempo sin perder estudios elegibles? ¿Reduce el uso de un LLM el tiempo de extracción de datos sin perder precisión?
Tabla 1. Diferencias entre la pregunta sustantiva de la revisión anfitriona y la pregunta metodológica del SWAR.
Como parte de los procesos y datos necesarios que ya se generan durante la revisión anfitriona, un SWAR puede ser más eficiente que un estudio metodológico completamente independiente, aunque exige planificación, coordinación y recursos adicionales. Su antecedente análogo en el ámbito de los ensayos clínicos es el Study Within A Trial (SWAT), un estudio metodológico integrado en uno o varios ensayos para evaluar distintas formas de desarrollar sus procesos (2).
¿Qué aspectos puede estudiar?
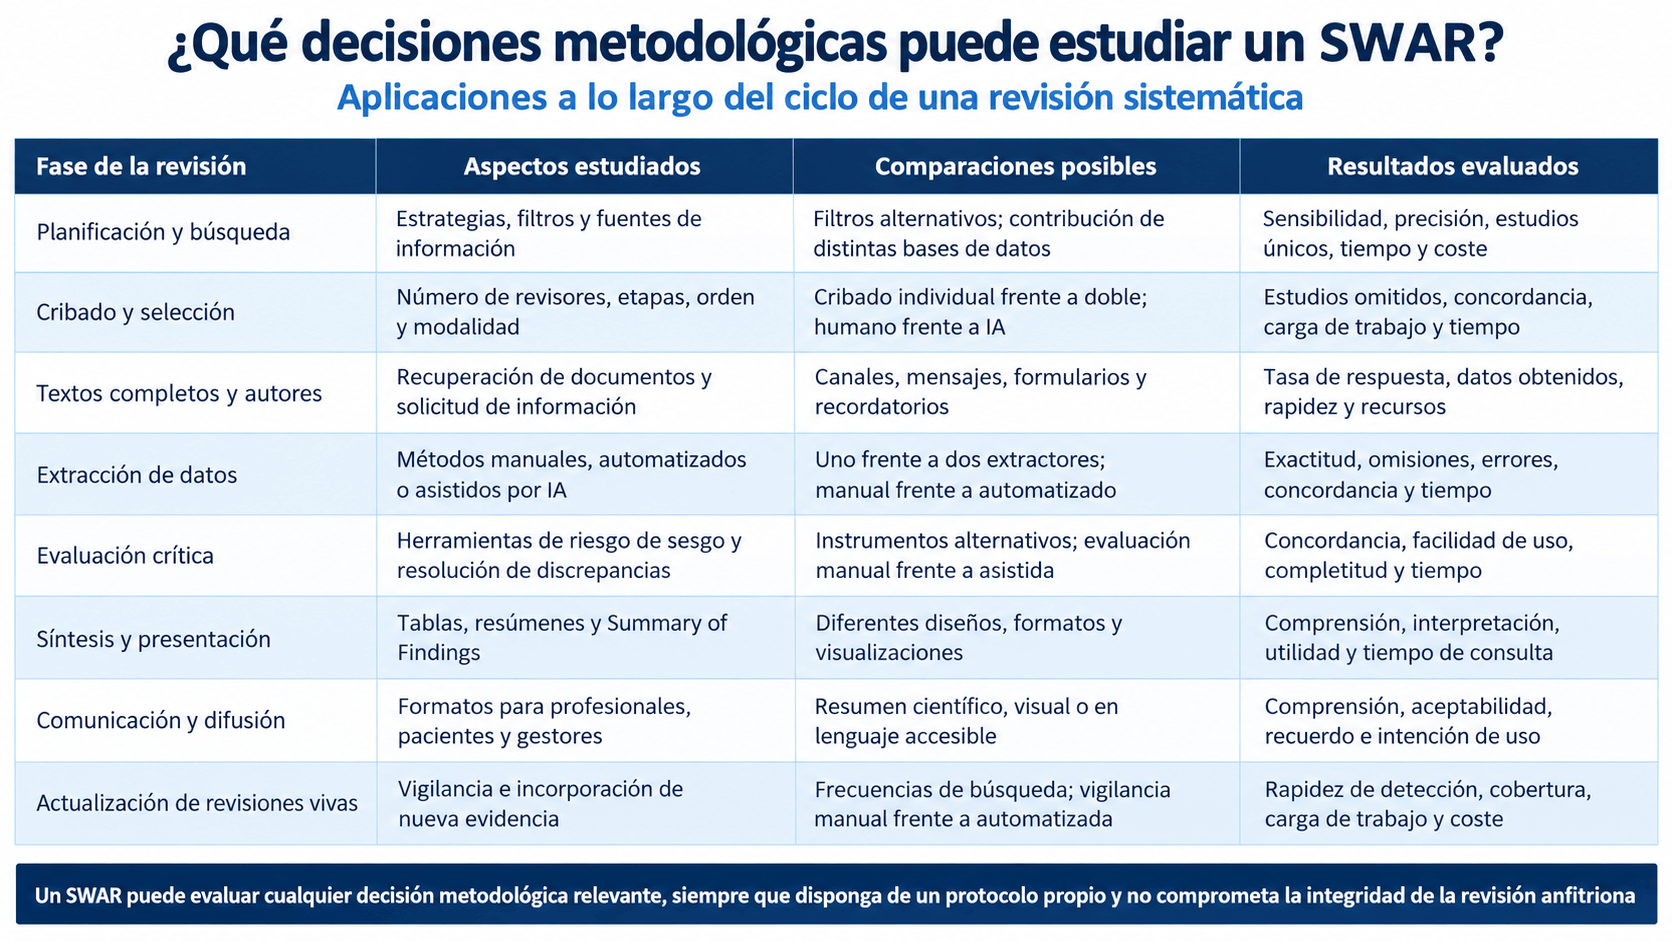
Un SWAR puede evaluar prácticamente cualquier decisión metodológica del ciclo de una revisión, admitiendo diseños diversos (aleatorizados, no aleatorizados o cualitativos).
Figura 1. Decisiones metodológicas que pueden evaluarse mediante un SWAR a lo largo del ciclo de una revisión sistemática.
Para considerarlo propiamente un SWAR, debe existir una incertidumbre metodológica explícita, una pregunta preespecificada, un protocolo independiente y una recogida y análisis sistemáticos de los datos. Se recomienda además su registro prospectivo.
Oportunidades para especialistas en información
Los bibliotecarios pueden liderar estudios sobre la sensibilidad de filtros de búsqueda, el uso de herramientas de minería de textos o la efectividad de procesos de deduplicación. Un ejemplo reciente especialmente relevante para los especialistas en información es el SWAR de Dullea et al. (3), integrado en 12 revisiones. El estudio comparó estrategias de búsqueda en MEDLINE construidas mediante tablas de frecuencia de términos generadas por PubReMiner con estrategias convencionales elaboradas y revisadas por bibliotecarios expertos. Las búsquedas basadas en PubReMiner fueron generalmente más rápidas, pero mostraron una sensibilidad inferior e inconsistente, por lo que los autores no recomendaron sustituir con ellas los procedimientos convencionales. El estudio muestra cómo un SWAR permite someter a evaluación empírica herramientas y procedimientos que podrían parecer eficientes a priori.
Ventajas, limitaciones y riesgos de hacer un SWAR
Es un requisito fundamental que el SWAR no comprometa la calidad, integridad, calendario ni objetivos de la revisión anfitriona. Por ejemplo, si se comparan dos métodos de cribado y uno pudiera omitir estudios relevantes, debe existir un mecanismo de seguridad que garantice que la revisión principal no queda incompleta.
Figura 2. Principales ventajas, limitaciones y riesgos asociados a la realización de un SWAR. La necesidad de evaluación ética debe determinarse según el diseño del estudio y la normativa aplicable.
¿Para qué sirven?
Los SWAR trasladan los principios de la práctica basada en la evidencia a los propios métodos de revisión. Al evaluar empíricamente cómo buscamos, seleccionamos, extraemos, analizamos y comunicamos la evidencia, pueden contribuir a que las futuras síntesis sean más rigurosas y eficientes.
En definitiva, un SWAR convierte una revisión en un entorno de investigación metodológica: además de sintetizar la evidencia sobre un tema, permite evaluar rigurosamente cómo mejorar la realización de futuras revisiones.
Bibliografía
Devane D, Burke NN, Treweek S, Clarke M, Thomas J, Booth A, et al. Study within a review (SWAR). J Evid Based Med. 2022;15(4):328-332. doi: 10.1111/jebm.12505
Clarke M, Devane D, Lang T, et al. Facilitating research on research using SWAR (studies within a review) and SWAT (studies within a trial). Evidence-Informed Public Health: Opportunities and Challenges. Abstracts of the 22nd Cochrane Colloquium; 21–26 Sep. Hyderabad, India: John Wiley & Sons; 2014.
Dullea A, Carrigan M, O’Sullivan L, et al. Sensitivity and precision of search strategies built using a text-mining word frequency tool (PubReMiner) compared to current best practice for building search strategies: a Study Within a Review (SWAR). Cochrane Evid Synth Methods. 2026;4(2):e70074. doi: 10.1002/cesm.70074.
Los registros de ensayos clínicos permiten identificar estudios en curso, no publicados o interrumpidos, pero también plantean problemas de deduplicación, vinculación y análisis. Esta guía explica cómo buscarlos, gestionarlos e incorporarlos correctamente a una revisión sistemática.
Introducción
Las bases de datos bibliográficas, como MEDLINE o Embase, recuperan principalmente documentos publicados. Los registros de ensayos clínicos permiten localizar los estudios desde su inicio, incluidos ensayos en curso, finalizados pero no publicados, interrumpidos o con resultados disponibles únicamente en el propio registro.
Su utilidad no termina en la búsqueda. Los registros también ayudan a reconstruir la historia de cada ensayo, relacionar protocolos y publicaciones, detectar cambios en los desenlaces previstos y valorar el posible sesgo debido a resultados ausentes. Por ello, su consulta no debería considerarse una tarea complementaria menor, sino una parte planificada de las revisiones sistemáticas de intervenciones.
Esta guía explica por qué, dónde y cómo buscar, pero también qué hacer con los registros recuperados: cómo deduplicarlos, vincularlos con sus publicaciones, clasificarlos, incorporarlos a la síntesis y notificarlos de forma transparente.
Antes de empezar: el estudio no es el documento.
La distinción metodológica más importante es la que existe entre estudio, registro, informe y resultado.
Concepto
Qué representa
Ejemplo
Estudio o ensayo
La investigación realizada con un grupo definido de participantes
Ensayo aleatorizado que compara albúmina con cristaloides
Registro
Ficha electrónica que describe el ensayo en un registro público
NCT04356859 en ClinicalTrials.gov
Informe del estudio
Cualquier documento que aporta información sobre el ensayo
Artículo, protocolo, resumen de congreso, informe regulatorio o registro
Resultado
Estimación correspondiente a un desenlace, momento y análisis concretos
Riesgo relativo de mortalidad a los 28 días
Un único ensayo puede generar varios registros e informes: una ficha en ClinicalTrials.gov, otra en un registro europeo o nacional, un protocolo publicado, un resumen de congreso, el artículo principal y varias publicaciones secundarias.
Todos estos documentos deben agruparse bajo un único identificador de estudio. Si el registro y el artículo se tratan como dos estudios independientes, existe el riesgo de contar dos veces a los mismos participantes y sesgar la síntesis o el metanálisis. El Manual Cochrane establece que el estudio y no cada uno de sus informes debe constituir la unidad de interés de la revisión (1-2).
¿Qué aportan realmente las búsquedas en registros?
Los registros de ensayos clínicos pueden ayudar a:
Identificar ensayos en curso o todavía no publicados.
Localizar ensayos finalizados, interrumpidos o retirados.
Obtener resultados no disponibles en artículos científicos.
Encontrar protocolos, planes de análisis, modificaciones y publicaciones relacionadas.
Comparar los desenlaces planificados con los finalmente publicados.
Estimar la cantidad de evidencia elegible cuyos resultados no están disponibles.
Valorar el posible sesgo de publicación o de notificación selectiva.
Planificar cuándo debería actualizarse la revisión.
La evidencia empírica permite matizar su rendimiento. En una muestra de 117 revisiones sistemáticas publicadas en revistas médicas generales, solo 41 (el 35 %) declararon haber buscado en algún registro. Entre las 29 revisiones que detallaron sus resultados, 15 identificaron al menos un ensayo finalizado y 18 al menos un ensayo en curso (3).
En otro estudio, en el que se reprodujeron búsquedas en registros para 101 revisiones que no los habían consultado, se identificaron ensayos elegibles adicionales para el 63 % de las revisiones. Sin embargo, solo en el 20 % se encontraron nuevos ensayos con resultados utilizables en un metaanálisis. Su incorporación no modificó, en promedio, las estimaciones combinadas, aunque sí mejoró el conocimiento sobre la cantidad de evidencia existente y sobre el posible sesgo debido a resultados ausentes (4).
Por tanto, el valor de los registros no debe medirse únicamente por su capacidad para cambiar el resultado numérico de un metaanálisis. También aportan información sobre la integridad, transparencia y vigencia del conjunto de evidencia.
Paso 1. Planificar la búsqueda
Qué registros se consultarán y por qué.
Qué conceptos y términos se buscarán.
Qué interfaces, campos, límites o filtros se utilizarán.
Cómo se exportarán y conservarán los resultados.
Cómo se deduplicarán los registros.
Cómo se identificarán registros múltiples del mismo ensayo.
Cómo se vincularán con protocolos y publicaciones.
Cómo se tratarán los ensayos en curso, interrumpidos o sin resultados.
Qué fuentes se priorizarán si existen datos discrepantes.
Sí se contactará con investigadores o promotores.
Cuándo se actualizarán las búsquedas.
Esta planificación reduce el riesgo de tomar decisiones condicionadas por la dirección o disponibilidad de los resultados y se alinea con las recomendaciones destinadas a reducir el sesgo de diseminación (5).
Paso 2. Seleccionar los registros
ClinicalTrials.gov y WHO ICTRP como punto de partida.
Aunque ClinicalTrials.gov aporta registros al portal ICTRP, Cochrane recomienda buscar ambos recursos por separado. La recuperación no es necesariamente idéntica y ClinicalTrials.gov proporciona funcionalidades adicionales, entre ellas la consulta detallada de resultados, publicaciones relacionadas y versiones anteriores del registro (2-6).
Fuente
Características y cobertura
Consideraciones metodológicas
ClinicalTrials.gov
Registro internacional de gran tamaño, especialmente útil para estudios farmacológicos, dispositivos y ensayos con participación estadounidense.
Debe buscarse directamente, aunque sus registros también se transfieran al ICTRP.
WHO ICTRP
Portal que reúne datos procedentes de registros primarios de numerosos países y regiones.
Amplía la cobertura geográfica y agrupa, cuando los identifica, registros múltiples del mismo ensayo.
CTIS
Ensayos clínicos de medicamentos tramitados en la Unión Europea y el Espacio Económico Europeo bajo el Reglamento europeo vigente.
Especialmente relevante cuando la revisión incluye medicamentos investigados en Europa.
EU Clinical Trials Register
Ensayos gestionados bajo la normativa europea anterior y determinados ensayos pediátricos
Continúa siendo relevante para estudios históricos anteriores a CTIS.
Registros nacionales o regionales
ANZCTR, ChiCTR, CTRI, DRKS, ISRCTN y otros.
Deben añadirse cuando la intervención, población o contexto geográfico lo justifique.
Registros especializados
Registros centrados en determinadas enfermedades, intervenciones o promotores.
Útiles cuando aportan cobertura no representada en los registros generales.
El WHO ICTRP proporciona un punto de acceso a datos suministrados por registros que cumplen los criterios de contenido y calidad de la OMS. Además, intenta agrupar las inscripciones múltiples correspondientes al mismo ensayo. Sin embargo, un metarregistro no elimina necesariamente la necesidad de consultar directamente determinadas fuentes (7).
En Europa debe prestarse atención a la transición entre el EU Clinical Trials Register y CTIS (información oficial de la EMA sobre el Reglamento y CTIS). Desde el 31 de enero de 2023, todas las nuevas solicitudes de ensayos clínicos en la Unión Europea y el Espacio Económico Europeo deben presentarse mediante CTIS. Desde el 31 de enero de 2025, el Reglamento (UE) n.º 536/2014 es plenamente aplicable y los ensayos que continuaban bajo la Directiva anterior debían haberse transferido al nuevo sistema. El EU Clinical Trials Register sigue siendo necesario para recuperar información sobre ensayos tramitados conforme al marco normativo anterior (8).
Para una revisión sistemática exhaustiva de intervenciones, el planteamiento adecuado sería:
Buscar en CENTRAL, MEDLINE y Embase, cuando esté disponible, para localizar informes publicados, resúmenes de congresos y otros documentos.
Buscar separadamente en ClinicalTrials.gov y WHO ICTRP para identificar ensayos registrados, en curso, interrumpidos, no publicados o con resultados depositados únicamente en el registro.
Añadir CTIS, EU Clinical Trials Register u otros registros nacionales o especializados cuando la intervención, el periodo o el ámbito geográfico lo justifiquen.
Vincular posteriormente todos los registros, protocolos y publicaciones que correspondan al mismo ensayo.
Dudas frecuentes de buscar en CENTRAL y Embase vs. registros originales
¿Basta con buscar en CENTRAL o Embase?
No. Aunque ambas bases incorporan actualmente registros procedentes de ClinicalTrials.gov —y CENTRAL también registros procedentes de WHO ICTRP—, una búsqueda en ellas no debe considerarse equivalente a la consulta directa de los registros originales (2,6,9).
La recomendación metodológica no consiste en buscar en ClinicalTrials.gov o WHO ICTRP en lugar de CENTRAL o Embase. Las bases bibliográficas y los registros deben utilizarse de forma complementaria porque responden a preguntas diferentes:
CENTRAL, MEDLINE y Embase se utilizan principalmente para localizar informes de ensayos: artículos, resúmenes de congresos y otros documentos.
ClinicalTrials.gov y WHO ICTRP permiten identificar los ensayos registrados, con independencia de que hayan generado una publicación.
¿Qué evidencia existe?
Banno y colaboradores evaluaron si CENTRAL podía sustituir las búsquedas en ClinicalTrials.gov e ICTRP. De 247 registros de ensayos en curso o no publicados incluidos en 50 revisiones Cochrane, CENTRAL recuperó 200 y no identificó 47. La sensibilidad fue del 81 % (intervalo de confianza del 95 %: 76-85 %) (11).
El estudio utilizó búsquedas realizadas en 2019, por lo que ese porcentaje no debe extrapolarse directamente al CENTRAL actual. Sin embargo, la edición vigente del Manual Cochrane continúa señalando que las búsquedas directas en ClinicalTrials.gov e ICTRP pueden localizar registros e información no identificables en CENTRAL (2-6).
Otra evaluación demostró la complementariedad de las fuentes. De 81 ensayos finalizados con resultados disponibles, siete se localizaron exclusivamente mediante búsquedas en registros y ocho exclusivamente mediante bases bibliográficas. De los 42 ensayos en curso identificados, 26 (el 62 %) fueron localizados únicamente mediante la búsqueda registral (12). Al tratarse de un estudio de caso sobre una temática determinada, estos porcentajes no son necesariamente generalizables. Sin embargo, muestran que ninguna de las dos aproximaciones identifica por sí sola todos los ensayos.
¿Tienen la misma cobertura?
No. CENTRAL incluye registros de ensayos aleatorizados o cuasialeatorizados identificados en ClinicalTrials.gov, WHO ICTRP y otras fuentes. No incorpora todos los diseños ni todos los metadatos del registro original. Los registros procedentes de ClinicalTrials.gov no incluyen en CENTRAL los resultados depositados ni indican necesariamente si existen resultados o publicaciones asociadas. EMBASE incluye actualmente más de 552.000 registros de ClinicalTrials.gov y ofrece 37 campos procedentes de esta fuente, pero no tiene una cobertura equivalente del conjunto de registros integrados en WHO ICTRP. ClinicalTrials.gov incluye el registro original y repositorio de resultados. Permite acceder al registro completo, a sus resultados, publicaciones relacionadas y al historial de cambios. El Portal WHO ICTRP integra datos de registros primarios y proveedores de diferentes países y regiones. Amplía la cobertura más allá de ClinicalTrials.gov y enlaza con los registros originales
¿Tienen la misma finalidad?
La búsqueda bibliográfica responde principalmente a la pregunta: ¿Qué documentos se han publicado sobre este ensayo? La búsqueda en registros responde además a otra pregunta: ¿Qué ensayos se iniciaron, incluidos los que continúan en curso, se interrumpieron o nunca publicaron sus resultados? Esta segunda pregunta es esencial para valorar el sesgo de publicación y la evidencia ausente. Si únicamente se buscan publicaciones, el conjunto localizado puede sobrerrepresentar los estudios con resultados positivos, favorables o estadísticamente significativos.
Paso 3. Traducir la pregunta de revisión a una estrategia específica para registros
Las estrategias de MEDLINE no deben copiarse literalmente en ClinicalTrials.gov, ICTRP o CTIS. Sus campos, sistemas de sinonimia, operadores, posibilidades de truncamiento y límites son diferentes.
La guía de Hunter y colaboradores recomienda comenzar con uno o dos conceptos centrales de la pregunta, normalmente la población o condición y la intervención.
El comparador y los desenlaces suelen omitirse porque no siempre se describen de manera consistente en los registros y pueden reducir la sensibilidad. Tampoco suele ser necesario incorporar un filtro de ensayo clínico cuando se busca en un registro dedicado principalmente a estudios clínicos (1).
Paso 4. Documentar y exportar los resultados
Por cada búsqueda debe conservarse:
Nombre del registro.
Dirección web o interfaz empleada.
Modalidad de búsqueda: básica, avanzada o mediante API.
Fecha exacta.
Estrategia copiada tal como fue ejecutada.
Campos consultados.
Filtros o límites.
Número de resultados.
Formato de exportación.
Nombre de la persona que realizó la búsqueda.
Captura de pantalla o copia de la página de resultados cuando ayude a preservar la trazabilidad.
Conviene conservar los archivos originales de cada registro sin modificarlos y trabajar sobre una copia integrada. ClinicalTrials.gov permite descargar registros en CSV, JSON, RIS y otros formatos (13) ICTRP permite exportar los resultados en XML (7). CTIS ofrece funciones de búsqueda y descarga (8).
Paso 5. Crear un fichero maestro centrado en el estudio
Los registros recuperados pueden gestionarse en una hoja de cálculo, un gestor de referencias, una base de datos o una herramienta de revisión. Sin embargo, debería existir un fichero maestro que permita reconstruir la relación entre estudios y documentos.
Paso 6. Deduplicar en dos niveles diferentes
Primer nivel: registros duplicados
Son copias del mismo registro recuperadas mediante diferentes búsquedas o fuentes. Comparten el mismo identificador, por ejemplo, el mismo número NCT.
Estos duplicados pueden eliminarse conservando la versión más completa y reciente, aunque debe mantenerse la trazabilidad de la fuente mediante la que se recuperaron.
Segundo nivel: registros múltiples del mismo ensayo
Un ensayo puede haberse registrado en ClinicalTrials.gov, CTIS y otro registro nacional, recibiendo identificadores distintos.
No son duplicados documentales estrictos: pueden contener información diferente o haberse actualizado en momentos distintos. En lugar de borrar uno de ellos, deben conservarse y agruparse bajo un único identificador interno de estudio.
Paso 7. Vincular los registros con protocolos y publicaciones
No debe confiarse exclusivamente en los enlaces incluidos automáticamente en el registro. Una revisión metodológica comprobó que la vinculación entre registros y publicaciones continúa necesitando búsquedas e inspección manual (14).
El proceso puede organizarse en tres niveles:
Vinculación automática: Revisar las publicaciones y referencias enlazadas en el registro.
Vinculación inferida: Buscar el identificador del ensayo en PubMed, Embase y otros buscadores. Si no aparece, combinar acrónimo, promotor, investigador, intervención, población, tamaño muestral, centros y fechas.
Vinculación mediante consulta: Contactar con investigadores o promotores cuando persistan dudas sobre la identidad del ensayo, su publicación o sus resultados.
Cada ensayo debería disponer de una “familia documental” que agrupe:
Registros primarios y secundarios.
Protocolo.
Plan de análisis estadístico.
Resúmenes de congresos.
Publicación principal.
Publicaciones de seguimiento.
Informes de seguridad.
Resultados depositados en registros.
Informes regulatorios.
Comunicaciones con los investigadores.
Paso 8. Cribar el registro completo y clasificar el ensayo
Un cribado preliminar por título puede utilizarse para eliminar registros manifiestamente irrelevantes, pero sus títulos suelen ser poco informativos. La decisión final debe adoptarse revisando el registro completo en la plataforma original.
En una revisión sistemática convencional, la selección debería realizarse por dos revisores de forma independiente (2). En una revisión rápida podría justificarse un proceso abreviado, pero debe declararse y valorarse el riesgo de perder estudios.
Paso 9. Incorporar los registros a la síntesis y a la evaluación del sesgo
Si el registro contiene resultados utilizables
Los datos pueden incorporarse a la síntesis narrativa o al metanálisis si:
El ensayo cumple los criterios de elegibilidad.
Los resultados corresponden a los desenlaces y momentos definidos.
Se conocen los denominadores y la población analizada.
Existen datos suficientes para calcular el efecto y su precisión.
No se está duplicando información ya incluida desde otra publicación.
La procedencia y las limitaciones de los datos se notifican claramente.
La ausencia de publicación en una revista no constituye, por sí sola, un motivo para excluir resultados elegibles. Tampoco debe confundirse la falta de revisión por pares con una evaluación formal del riesgo de sesgo.
Si se conoce el ensayo, pero sus resultados no están disponibles
El ensayo no puede aportar una estimación numérica, pero no debe desaparecer de la revisión. Su existencia, tamaño previsto, fecha de finalización y desenlaces registrados ayudan a valorar el riesgo de sesgo debido a evidencia ausente.
Comparación entre planificación y publicación
Para aplicar el dominio de RoB 2 relativo a la selección del resultado comunicado, debe examinarse si el resultado incluido coincide con un plan de análisis definido antes de que los datos estuvieran disponibles.
Un registro retrospectivo o modificado después del análisis no proporciona la misma garantía que un protocolo o registro prospectivo suficientemente detallado (17).
A nivel de la síntesis, ROB-ME permite valorar el riesgo de sesgo debido a estudios completos o resultados concretos ausentes por su significación, magnitud o dirección. La evaluación debe integrar los ensayos identificados sin resultados, las discrepancias entre fuentes y otros indicios de falta selectiva de evidencia (18).
La mera existencia de una discrepancia no obliga automáticamente a reducir la certeza de la evidencia. Su importancia dependerá del desenlace afectado, la magnitud de los datos ausentes, la plausibilidad de selección y el posible efecto sobre la estimación.
Paso 10. Actualizar la búsqueda
Los registros cambian: un ensayo en curso puede finalizar, aparecer una publicación, depositarse resultados o modificarse su estado.
En la actualización se debe:
Repetir la estrategia original o justificar sus modificaciones.
Buscar registros nuevos por fecha de registro, dejando un pequeño solapamiento entre periodos.
Revisar nuevamente los registros ya identificados.
Comprobar cambios de estado.
Buscar resultados y publicaciones añadidas.
Actualizar las tablas de estudios en curso y pendientes de clasificación.
La frecuencia debe adaptarse a la velocidad de producción de evidencia. Una revisión viva puede necesitar búsquedas mensuales o trimestrales; una revisión convencional, una actualización próxima al cierre editorial.
Paso 11. Informar siguiendo PRISMA 2020 y PRISMA-S
PRISMA 2020 proporciona diagramas específicos para revisiones que identifican estudios mediante bases de datos y registros. El diagrama debe distinguir entre:
Registros recuperados.
Registros duplicados eliminados.
Registros cribados.
Informes buscados y evaluados.
Estudios finalmente incluidos.
Esta distinción permite que varios registros, protocolos y artículos terminen agrupados como un único estudio (19).
PRISMA-S recomienda informar:
Todos los registros consultados.
Nombre y enlace de cada fuente.
Estrategias completas tal como se ejecutaron.
Fechas de búsqueda.
Límites y filtros, o la ausencia de ellos.
Número de resultados de cada fuente.
Proceso y programas de deduplicación.
Métodos de actualización.
Revisión por pares de la estrategia, si se realizó (20).
También deben citarse los registros de los ensayos incluidos, indicando su identificador y URL estable, igual que se citan los demás informes del estudio (1-2,20).
En conclusión
Buscar en registros de ensayos clínicos no consiste simplemente en añadir otra base de datos a la estrategia bibliográfica. Requiere trabajar con una lógica centrada en el estudio: identificar el ensayo, reunir todos sus registros e informes, reconstruir su evolución y determinar qué información puede utilizarse con suficiente confianza.
CENTRAL y Embase son fuentes fundamentales y contienen actualmente registros procedentes de ClinicalTrials.gov. Sin embargo, su cobertura, estructura, funcionalidades e información disponible no son equivalentes a las de los registros originales. La recomendación metodológica no consiste en elegir entre unas fuentes u otras, sino en utilizarlas de manera complementaria.
El error más importante no es solo omitir un ensayo no publicado. También lo es encontrar su registro y tratarlo como si fuera un estudio diferente del artículo que posteriormente comunica sus resultados.
Una gestión adecuada convierte los registros en algo más que una fuente de literatura gris: los transforma en una herramienta para evaluar la integridad del conjunto de evidencia, detectar resultados ausentes y producir revisiones sistemáticas más transparentes y fiables.
En una revisión sistemática, el procedimiento habitual consiste en importar primero las referencias bibliográficas recuperadas en las bases de datos, hacer el cribado frente a título y resumen y, aquellas que pasan a la segunda fase de cribado, asociar a cada registro su correspondiente texto completo.
El problema que describo en esta entrada aparece en ese segundo momento: la referencia está correctamente importada en Rayyan, pero la plataforma no permite adjuntarle determinados PDF creados o modificados por nosotros.
Flujo de trabajo en la importación de los textos completos en una revisión sistemática.
Los documentos se abrían con normalidad en mi ordenador, todas sus páginas eran visibles y no parecían estar dañados. Sin embargo, Rayyan no conseguía procesarlos o asociarlos a la referencia correspondiente.
Una herramienta de inteligencia artificial me ayudó a analizar los archivos, comprender que el problema no estaba en las referencias bibliográficas, sino en la estructura interna de los PDF, y determinar qué transformaciones eran necesarias. También me ayudó a procesar los documentos y a generar nuevas versiones normalizadas que finalmente pude subir y asociar correctamente en Rayyan.
El problema no estaba en el archivo RIS
Las referencias ya habían sido importadas previamente en Rayyan mediante archivos RIS procedentes de las bases de datos o de los registros correspondientes.
El fallo se producía exclusivamente al intentar adjuntar el texto completo a una referencia ya existente.
Aunque la referencia estuviera perfectamente identificada, Rayyan podía rechazar el PDF por sus características técnicas internas.
Casos en los que encontré problemas
1. Artículos unidos a su material suplementario
En mi práctica habitual, cuando un artículo dispone de material suplementario, creo un único documento PDF en el que, al texto completo del artículo, le añado al final el material suplementario.
Este procedimiento resulta útil porque permite conservar conjuntamente toda la documentación necesaria para evaluar si el estudio pasa el segundo screening y para la posterior extracción de datos. Evita, además, que el suplemento quede separado o se pierda durante el proceso de revisión.
Sin embargo, el artículo principal y los suplementos pueden haberse generado con aplicaciones diferentes y presentar:
Versiones distintas del estándar PDF.
Tamaños y orientaciones de página diferentes.
Capas de texto incompatibles.
Fuentes incrustadas de forma distinta.
Anotaciones, formularios o enlaces.
Páginas digitales combinadas con páginas escaneadas., …
Aunque el documento combinado pueda abrirse sin problemas en un lector convencional, internamente puede seguir siendo un archivo heterogéneo. Rayyan puede no procesarlo correctamente y rechazarlo al intentar asociarlo a la referencia.
2. Páginas web impresas o guardadas como PDF
Otro caso frecuente aparece cuando no existe una opción para descargar un PDF y necesitamos conservar el contenido de una página web.
Es habitual en plataformas de registro de ensayos clínicos, informes publicados exclusivamente en HTML, etc.
En estas situaciones utilizo las opciones del navegador Imprimir o Guardar como PDF.
El archivo resultante puede visualizarse como un PDF normal, pero su estructura interna conserva elementos procedentes de la página web:
Cabeceras y pies de impresión.
URL y fecha de consulta.
Menús de navegación.
Avisos legales.
Hipervínculos.
Fuentes web.
Elementos ocultos.
Texto dividido en numerosos objetos. …
En algunos de los archivos, el contenido es perfectamente legible, pero no existía una capa de texto extraíble. En otros, el PDF generado por el navegador contiene una estructura que Rayyan no puede procesar correctamente.
3. Suplementos de revistas que incluyen muchos resúmenes de congreso
También encontré problemas con suplementos de revistas que recogen todas las comunicaciones orales y póster de un congreso.
El PDF tiene un PDF único e incluye:
Varios títulos.
Diferentes grupos de autores.
Distintos números de resumen.
Información correspondiente a varios estudios.
Aunque solo necesitaba asociar uno de los resúmenes, el archivo contenía varias referencias potenciales. En este caso fue necesario recortar la página y generar un PDF nuevo que incluyera únicamente el resumen pertinente.
4. PDF sin texto extraíble o con una capa defectuosa
En otros documentos, el texto era visible, pero no podía seleccionarse o buscarse. En algunos casos, al copiarlo aparecían caracteres desordenados o ilegibles.
Esto puede ocurrir cuando:
El documento está formado por imágenes.
La codificación de las fuentes es defectuosa.
La capa de texto no coincide con la imagen.
Se han superpuesto varias capas de OCR.
El PDF procede de una digitalización o conversión deficiente.
Añadir simplemente otra capa de OCR no siempre resuelve el problema. Si ya existe una capa de texto incorrecta, puede ser necesario reconstruir previamente el documento.
Cómo me ayudó la inteligencia artificial
La inteligencia artificial tuvo un papel práctico en varias fases del proceso.
Análisis del problema. La primera aportación fue ayudarme a diferenciar entre un problema bibliográfico y un problema técnico del PDF. La herramienta de inteligencia artificial me ayudó a determinar que no bastaba con aplicar OCR o guardar de nuevo el documento. En los casos problemáticos fue necesario realizar una combinación de operaciones:
Reconstruir el PDF.
Homogeneizar las páginas.
Eliminar estructuras internas innecesarias.
Recortar contenido no pertinente.
Aplicar OCR cuando era necesario.
Incorporar metadatos básicos.
Simplificar el nombre del archivo.
Procesamiento de los documentos. En los casos problemáticos fue necesario realizar una combinación de operaciones:
Reconstruir el PDF.
Homogeneizar las páginas.
Eliminar estructuras internas innecesarias.
Recortar contenido no pertinente.
Aplicar OCR cuando era necesario.
Incorporar metadatos básicos.
Simplificar el nombre del archivo.
Procesar los archivos y generar nuevas versiones técnicamente más sencillas. De esta forma se eliminaron o neutralizaron muchos elementos que podían causar incompatibilidades, como, por ejemplo, capas defectuosas.
Después se incorporó una nueva capa de texto mediante OCR cuando era necesario. Los PDF resultantes pudieron subirse y asociarse a las referencias correspondientes en Rayyan.
En mis documentos fue necesario: Reconstruir el PDF, simplificar su estructura, aplicar OCR cuando procedía, normalizar sus metadatos y cambiar el nombre del archivo.
Controles necesarios después del procesamiento
La utilización de inteligencia artificial no elimina la necesidad de revisión humana. Después de generar cada PDF comprobé:
Que estaban todas las páginas.
Que se había respetado el orden original.
Que no se había eliminado contenido relevante.
Que el artículo y el suplemento estaban completos.
Que el OCR no modificaba la imagen visible.
Que el título y el identificador eran correctos.
Que el archivo podía abrirse.
Que el PDF se asociaba a la referencia adecuada.
Conclusión
Cuando Rayyan no permite asociar un texto completo, el problema no siempre está en la plataforma ni en la referencia bibliográfica. Con frecuencia se encuentra en la estructura interna del PDF.
Esto puede suceder especialmente con:
Artículos unidos a su material suplementario.
Páginas web impresas o guardadas como PDF.
Suplementos de revistas con varios resúmenes.
PDF con capas de texto defectuosas.
En esta experiencia, la inteligencia artificial me ayudó a comprender qué estaba ocurriendo, identificar una solución técnica y procesar los documentos hasta obtener archivos compatibles con Rayyan.
La inteligencia artificial fue, en este caso, una herramienta de apoyo técnico. Permitió diagnosticar y resolver un problema que no era evidente al abrir los documentos, pero la comprobación final de la integridad, correspondencia y fidelidad de los PDF siguió siendo responsabilidad de la persona que realizaba la revisión.
Cuando hablamos de revisiones de la literatura, es frecuente asumir que todas requieren una búsqueda exhaustiva en numerosas bases de datos. Sin embargo, la realidad metodológica es más compleja. La estrategia de búsqueda debe responder al objetivo de la revisión, a la pregunta de investigación, al tipo de evidencia que se pretende identificar y al uso previsto de los resultados.
No busca del mismo modo quien pretende contextualizar un tema que quien necesita estimar la efectividad de una intervención, identificar lagunas de conocimiento o mantener actualizada una síntesis de evidencia. Aunque todas estas finalidades requieren localizar y seleccionar información, difieren en el grado de exhaustividad, la estructura de la búsqueda, las fuentes consultadas y los procedimientos de actualización.
La búsqueda varía según el objetivo de la revisión: describir, integrar, mapear, sintetizar, resumir revisiones previas o mantener la evidencia actualizada.
La tabla que acompaña esta entrada resume estas diferencias y muestra cómo cambian la planificación, las fuentes consultadas, la sensibilidad de la estrategia y el grado de reproducibilidad exigido.
Principales diferencias en la planificación y ejecución de la búsqueda bibliográfica según el tipo y la modalidad de revisión.
De la búsqueda narrativa a la búsqueda sistemática: distintos grados de estructuración y reproducibilidad
En una revisión narrativa, la selección de las fuentes suele depender en gran medida del criterio de los autores. La búsqueda puede ser flexible y no siempre se documenta de forma suficiente para que otras personas puedan reproducirla. Este enfoque puede resultar útil para introducir un tema, explicar conceptos o presentar una perspectiva experta, pero ofrece menos garantías frente al sesgo de selección.
La revisión integrativa requiere una búsqueda más planificada y transparente. Su particularidad es que puede reunir estudios cuantitativos y cualitativos, documentos teóricos y literatura gris. Por ello, debe contemplar fuentes y estrategias capaces de identificar diseños muy diferentes.
En el extremo de mayor estructuración se encuentra la revisión sistemática. Su búsqueda parte de una pregunta, formulada habitualmente mediante PICO u otro marco equivalente, y de unos criterios de elegibilidad establecidos previamente. Debe identificar de forma sistemática los estudios relevantes, combinar varias bases de datos y métodos complementarios —como la búsqueda de literatura gris, el rastreo de citas o la revisión de referencias— y documentar íntegramente las estrategias utilizadas. Cochrane subraya que la búsqueda debe ser sistemática, exhaustiva dentro de lo razonable y reproducible.
Las búsquedas no se realizan igual en todos los tipos de revisión y que existe una transición desde enfoques más flexibles hacia otros más planificados, transparentes y reproducibles.
Mapear la evidencia no es lo mismo que estimar un efecto
Una revisión de alcance o un mapa de evidencia pregunta, por ejemplo: «¿Qué evidencia existe, cómo se distribuye y qué lagunas presenta?». Una revisión de efectividad pregunta: «¿Cuál es el efecto de una intervención, comparada con una alternativa, sobre unos resultados determinados?».
La revisión de alcance o scoping review busca conocer qué evidencia existe, cómo se ha investigado un tema, qué conceptos se utilizan y dónde se encuentran las principales lagunas de conocimiento.
Su pregunta suele ser amplia y se estructura frecuentemente mediante el marco PCC: población, concepto y contexto. En las revisiones de alcance puede ser necesario ampliar la diversidad de fuentes y vocabularios para captar distintos diseños, contextos y formas de publicación. No pretende necesariamente calcular un efecto, sino elaborar un mapa descriptivo de la literatura disponible.
En las revisiones de efectividad, la búsqueda suele organizarse a partir de los conceptos de la pregunta y debe optimizar la identificación de los diseños de estudio elegibles sin introducir restricciones injustificadas.
Una revisión de alcance utiliza el marco PCC para explorar, organizar y representar la evidencia disponible, identificar conceptos y localizar lagunas de conocimiento.
Cuando cambia la unidad de análisis, cambia también la búsqueda
La unidad de análisis es el tipo de objeto que la revisión pretende localizar y sintetizar: estudios primarios, revisiones, documentos, conceptos, intervenciones, experiencias, políticas o conjuntos de evidencia. Cuando cambia la unidad de análisis, cambian también las fuentes de información, los términos de búsqueda, los criterios de elegibilidad y los procedimientos de selección.
En una revisión paraguas, los documentos que se buscan no son estudios primarios, sino revisiones sistemáticas y metaanálisis. Esto obliga a emplear términos y filtros específicos para identificar síntesis de evidencia y a consultar recursos especializados. Además, debe prestarse atención al posible solapamiento de estudios primarios entre las revisiones incluidas.
Las síntesis cualitativas buscan experiencias, percepciones, significados y fenómenos humanos. La recuperación puede resultar especialmente compleja porque los estudios cualitativos presentan una terminología variable y una indexación menos consistente. Por ello, suelen combinarse bases de datos biomédicas y sociales —como MEDLINE, CINAHL o PsycINFO— con rastreo de referencias, búsqueda de citas, literatura gris y consulta a expertos.
Cuando cambia la unidad de análisis, cambia también la búsqueda.
En las revisiones de métodos mixtos deben localizarse simultáneamente evidencias cuantitativas y cualitativas. Puede diseñarse una búsqueda amplia y sensible para ambos componentes o desarrollar estrategias independientes que posteriormente confluyan en una síntesis integrada o segregada.
Revisiones rápidas y revisiones vivas: dos modalidades de ejecución y actualización
Conviene diferenciar los tipos de revisión de sus modalidades de ejecución. Las revisiones rápidas y las revisiones vivas pueden entenderse como modalidades de ejecución y actualización de una revisión. No son categorías definidas por el tema estudiado, sino enfoques relacionados con el tiempo disponible, la frecuencia de actualización y la organización del proceso de revisión.
Las revisiones rápidas responden a la necesidad de producir una síntesis en un plazo limitado. Para ello, pueden simplificar determinados procedimientos de la revisión, como el número de fuentes consultadas, la amplitud de la búsqueda, la selección por duplicado, la extracción de datos o ciertos procesos de síntesis. Estas decisiones deben estar justificadas, documentadas y acompañadas de una valoración de sus posibles efectos sobre la exhaustividad y el riesgo de sesgo.
Las revisiones vivas, por el contrario, se diseñan para mantenerse actualizadas. Parten de una revisión sistemática y establecen mecanismos periódicos o continuos para identificar nueva evidencia, evaluarla e incorporarla cuando pueda modificar las conclusiones. La automatización puede facilitar la vigilancia y la priorización de registros, pero no sustituye la supervisión metodológica. Una revisión viva debe mantener los estándares metodológicos de la revisión sistemática de la que parte.
La revisión rápida adapta el proceso para ganar tiempo; la revisión viva mantiene búsquedas periódicas para evitar que la revisión quede desactualizada; ambas son formas de ejecutar la revisión y la búsqueda, no categorías temáticas.
Una búsqueda adecuada es la que responde al propósito de la revisión
No existe una única estrategia válida para todas las revisiones. La búsqueda debe diseñarse en función de la pregunta, el propósito de la síntesis, la unidad de análisis, los criterios de elegibilidad, los recursos disponibles y la necesidad de actualización.
La búsqueda debe diseñarse teniendo en cuenta:
Preguntas esenciales para planificar una búsqueda bibliográfica adaptada al tipo de revisión.
En definitiva, una búsqueda de calidad no es necesariamente la que recupera más referencias, sino la que identifica de forma suficientemente completa y reproducible la evidencia pertinente para responder a la pregunta planteada. Sus decisiones, limitaciones y posibles sesgos deben quedar documentados con transparencia.
Referencias
Aromataris E, Lockwood C, Porritt K, Pilla B, Jordan Z, editores. JBI Manual for Evidence Synthesis. JBI; 2024. doi:10.46658/JBIMES-24-01.
Higgins JPT, Thomas J, Chandler J, Cumpston M, Li T, Page MJ, et al., editores. Cochrane Handbook for Systematic Reviews of Interventions. Version 6.5. Cochrane; 2024.
Garritty C, Hamel C, Trivella M, Gartlehner G, Nussbaumer-Streit B, Devane D, et al. Updated recommendations for the Cochrane rapid review methods guidance for rapid reviews of effectiveness. BMJ. 2024;384:e076335. doi:10.1136/bmj-2023-076335.
Synnot A. Updated guidance for Cochrane living systematic reviews. Cochrane Methods; 2020.
La eliminación de duplicados es una tarea aparentemente técnica y secundaria dentro de una revisión sistemática, pero tiene consecuencias metodológicas importantes. Si una herramienta elimina por error un registro único, el equipo puede perder un estudio potencialmente relevante antes de iniciar el cribado. Si, por el contrario, deja demasiados duplicados sin eliminar, aumenta la carga de trabajo durante la selección por título y resumen.
Un estudio reciente publicado en Research Synthesis Methods compara la precisión y la velocidad de ocho herramientas de deduplicación: ASySD (The Automated Systematic Search Deduplicator), Covidence, Deduklick, EPPI-Reviewer, PICO Portal, Rayyan, SRA Deduplicator: Focused y SRA Deduplicator: Relaxed.
Los autores utilizaron cinco conjuntos de registros procedentes de revisiones Cochrane y los compararon con conjuntos de referencia creados por especialistas en información. Evaluaron tres resultados principales: registros únicos eliminados por error, duplicados retenidos por error y tiempo total de deduplicación.
Resultados principales
El estudio evaluó tres desenlaces principales:
Registros únicos eliminados por error (false positives): registros que la herramienta consideró duplicados, aunque en realidad eran únicos. Es el error más crítico, porque puede hacer desaparecer estudios potencialmente elegibles.
Duplicados retenidos por error (false negatives): duplicados que la herramienta no detectó. Es un problema menor desde el punto de vista metodológico, pero aumenta la carga de cribado.
Tiempo total de deduplicación: incluye tanto el proceso automático como la revisión manual necesaria en algunas herramientas.
Desde el punto de vista metodológico, el desenlace más importante es la eliminación errónea de registros únicos. Un duplicado no eliminado puede detectarse más adelante durante el cribado. En cambio, un registro único eliminado antes del cribado puede desaparecer definitivamente del flujo de selección. En este sentido, Rayyan fue la herramienta más conservadora, con solo dos registros únicos eliminados por error. Sin embargo, este resultado se obtuvo a costa de un tiempo muy elevado de trabajo manual: más de veinte horas en total.
Por otro lado, ASySD fue la herramienta que menos duplicados dejó sin eliminar, pero también la que más registros únicos eliminó erróneamente. SRA Deduplicator: Relaxed fue la más rápida, pero retuvo muchos más duplicados que otras herramientas.
La siguiente tabla integra los resultados principales. En todos los casos, valores más bajos indican mejor rendimiento.
El mensaje más importante del estudio es que ninguna herramienta fue superior en los tres desenlaces. Todas presentaron fortalezas y debilidades.
¿Qué herramienta elegir?
Este estudio muestra que todas las herramientas evaluadas ofrecen un rendimiento suficientemente aceptable, pero ninguna domina claramente en todos los desenlaces. Por tanto, la pregunta práctica no debería ser “¿cuál es la mejor herramienta?”, sino “qué herramienta se ajusta mejor a las prioridades y recursos de este equipo de revisión”: tiempo disponible, presupuesto, necesidad de revisión manual y tolerancia al riesgo de perder registros únicos.
Para equipos de revisión, bibliotecarios médicos y especialistas en búsquedas, la lección práctica es clara: conviene documentar qué herramienta se utiliza, qué criterios se aplican y qué grado de revisión manual se realiza. La transparencia en la deduplicación forma parte de la calidad metodológica de la revisión.
Referencia
Bateup S, Fulbright H, Moberg K, Hair K, Peterson E, Stansfield CM, Qureshi R, Clark J. Evaluating the accuracy and speed of eight deduplication tools: A comparative study. Research Synthesis Methods. 2026;00:1-14. doi:10.1017/rsm.2026.10100.
Cada vez es más frecuente que profesionales sanitarios, docentes e investigadores utilicen herramientas de inteligencia artificial generativa para leer, resumir, traducir, organizar información o preparar documentos científicos. La pregunta aparece cada vez más en bibliotecas sanitarias: ¿Puedo subir un artículo a ChatGPT, Copilot, Gemini, Claude, Elicit, Consensus u otra herramienta de IA para que me lo resuma?
La respuesta breve sería: depende.
Pero la respuesta útil es algo más precisa:
No se trata de prohibir el uso de la inteligencia artificial. Se trata de saber qué contenidos podemos introducir, con qué licencia, en qué herramienta y para qué finalidad.
La cuestión no es solo la herramienta: es el contenido
Los recursos electrónicos suscritos por las bibliotecas, revistas, libros electrónicos, bases de datos, capítulos, textos completos, tablas, figuras o metadatos, están sujetos a licencias de uso firmadas con los proveedores y editores.
Estas licencias permiten determinados usos habituales: lectura, consulta, descarga razonable para uso personal, impresión, uso docente dentro de ciertos límites o incorporación de referencias a trabajos académicos. Sin embargo, no siempre permiten otros usos más recientes como cargar PDFs en herramientas externas de IA.
Por eso, tener acceso institucional a un recurso no significa automáticamente tener permiso para introducirlo en una herramienta de inteligencia artificial.
Usar IA sí; alimentar IA con contenidos licenciados, no siempre
Conviene evitar una interpretación equivocada. Las bibliotecas no están diciendo que no se pueda usar IA. Al contrario: la IA puede ser una herramienta útil para el trabajo clínico, docente e investigador si se usa de forma responsable.
El problema aparece cuando se introduce en una herramienta de IA contenido que no es propio y que está protegido por una licencia editorial: PDFs de artículos suscritos, capítulos de libros electrónicos, tablas, figuras, textos completos o grandes exportaciones de registros.
Dicho de forma sencilla:
Puedes usar IA para pensar mejor, buscar mejor y escribir mejor. Lo que no debes hacer, salvo autorización expresa del proveedor/editor, es cargar en herramientas externas de IA contenidos licenciados por la biblioteca.
Open access no significa siempre “puedo hacer cualquier cosa”
Otra duda frecuente es si pueden subirse a una herramienta de IA artículos open access.
La respuesta vuelve a ser: depende de la licencia.
No es lo mismo un artículo con licencia CC BY o CC0, que permite amplias formas de reutilización siempre que se respeten sus condiciones, que un artículo simplemente accesible de forma gratuita en la web, pero sin licencia clara.
Tampoco son equivalentes las licencias CC BY-NC, que restringen el uso comercial, o CC BY-ND, que limita la creación o distribución de obras derivadas. En esos casos, subir el contenido a una herramienta comercial de IA, traducirlo, adaptarlo o reutilizarlo de forma amplia puede requerir una valoración más cuidadosa.
Por tanto, no basta con comprobar si el artículo “se puede leer gratis”. Hay que revisar la licencia concreta.
Mapa de acceso: cinco zonas para decidir
Para facilitar la toma de decisiones, he preparado un mapa de acceso al uso de artículos científicos en herramientas de IA. La metáfora del mapa permite diferenciar cinco zonas, desde los usos más seguros hasta los no autorizados.
1. Zona libre
Incluye usos generalmente permitidos porque se trabaja con textos propios, consultas generales o datos bibliográficos mínimos.
2. Zona con condiciones
Incluye usos posibles, pero condicionados a que se respeten licencias, políticas institucionales o requisitos de atribución.
3. Zona de consulta o cautela
Incluye situaciones en las que no conviene asumir que el uso está permitido sin revisar antes la licencia, la herramienta y la finalidad.
4. Zona restringida con autorización
Incluye usos que, en general, requieren autorización expresa del proveedor/editor, de la licencia o de la institución.
5. Zona no autorizada
Incluye usos que, salvo autorización expresa del proveedor/editor, no deben realizarse con contenidos suscritos o licenciados.
Un dashboard interactivo para resolver dudas frecuentes
Además de la infografía, he preparado un dashboard interactivo con ejemplos de uso clasificados en cinco categorías:
Permitido.
Permitido con condiciones.
No permitido.
Dudoso / requiere cautela.
Requiere autorización expresa del proveedor/editor.
El objetivo del dashboard es facilitar la consulta rápida de casos prácticos. Permite filtrar por tipo de uso, revisar ejemplos concretos y orientar la respuesta ante dudas frecuentes de usuarios.
No sustituye la revisión de las licencias de cada proveedor ni constituye asesoramiento jurídico, pero puede ayudar a aplicar criterios prudentes y homogéneos en el uso cotidiano de recursos electrónicos e inteligencia artificial.
Preguntas frecuentes
¿Puedo subir un PDF descargado desde la biblioteca a ChatGPT para que me haga un resumen?
Si es un PDF procedente de un recurso suscrito y no hay autorización expresa del proveedor/editor, la respuesta prudente es no. Aunque el uso sea personal, la carga del archivo en una herramienta externa puede implicar copia, alojamiento, procesamiento o generación de resultados no autorizados por la licencia.
¿Y si solo pego un fragmento?
Depende del fragmento, de la licencia y de la finalidad. En general, no conviene pegar textos sustanciales de artículos o capítulos licenciados en herramientas externas. Si se trata de una cita breve para análisis propio, habrá que valorar el contexto; si se trata de resumir, traducir o reutilizar contenido licenciado, el riesgo aumenta.
¿Puedo usar IA para hacer una búsqueda bibliográfica?
Sí. Puedes utilizar IA para formular la pregunta, identificar conceptos, sugerir sinónimos, proponer términos controlados o revisar la lógica de una estrategia. Lo que no deberías hacer es cargar en la herramienta PDFs, textos completos o exportaciones masivas de contenidos licenciados sin autorización.
¿Puedo usar IA para una revisión sistemática?
Sí, pero con cautela. Puedes usar IA como apoyo metodológico, para estructurar preguntas, explorar términos, preparar formularios o revisar textos propios. Sin embargo, subir todos los PDFs descargados desde recursos suscritos a una herramienta de IA para cribado, extracción de datos, resumen o síntesis no debería hacerse salvo autorización expresa del proveedor/editor.
¿Y si uso una herramienta institucional como Copilot?
El hecho de que una herramienta sea institucional puede reducir algunos riesgos de privacidad o confidencialidad, pero no resuelve automáticamente el problema de las licencias editoriales. Que una herramienta declare que no entrena con los datos no significa necesariamente que la licencia permita cargar contenido suscrito en ella.
¿Puedo subir artículos open access?
Depende de la licencia. Los artículos con licencia CC BY o CC0 son los casos más claros, siempre citando correctamente la fuente. Los artículos “free access” sin licencia explícita, o aquellos con licencias CC BY-NC, CC BY-ND o combinaciones restrictivas, requieren mayor cautela.
El papel de la biblioteca
La biblioteca no está para frenar la innovación ni para impedir el uso de herramientas útiles. Su papel es ayudar a que el uso de la inteligencia artificial sea:
legalmente prudente;
metodológicamente responsable;
compatible con las licencias suscritas;
respetuoso con los derechos de autor;
seguro desde el punto de vista institucional;
útil para la práctica clínica, docente e investigadora.
Ante una duda concreta, lo más recomendable es consultar con la biblioteca antes de cargar contenidos editoriales en herramientas de IA, especialmente cuando se trate de textos completos, PDFs, capítulos, tablas, figuras, metadatos masivos o uso automatizado.
Conclusión
La inteligencia artificial puede ser una aliada valiosa para los profesionales sanitarios. Puede ayudarnos a pensar, buscar, organizar, redactar y aprender mejor. Pero su uso con contenidos científicos requiere conocer los límites impuestos por las licencias editoriales. La regla práctica es sencilla: Use IA con textos propios, consultas generales, referencias mínimas y contenidos abiertos cuya licencia lo permita. No suba a herramientas externas de IA contenidos suscritos por la biblioteca salvo autorización expresa del proveedor/editor. Ante la duda, consulte con la biblioteca. Mejor preguntar antes que comprometer el acceso institucional a recursos esenciales para la asistencia, la docencia y la investigación.
Nota: Esta entrada tiene finalidad orientativa y no sustituye la revisión de las licencias específicas de cada proveedor ni el asesoramiento jurídico institucional.
La IA puede procesar información, resumir documentos, sugerir términos, redactar textos aparentemente impecables y ayudarnos en muchas tareas. Pero no tiene responsabilidad profesional, no tiene memoria institucional, no entiende el daño que puede causar una mala evidencia en una decisión clínica y, desde luego, no va a presentarse en un comité a explicar por qué una revisión sistemática está mal planteada.
Su utilidad es enorme, pero sus límites también lo son. Y en ciencias de la salud esos límites no son un asunto menor: una respuesta convincente, pero falsa o metodológicamente débil, puede influir en decisiones clínicas, docentes, investigadoras o de gestión.
El valor del juicio crítico
Nuestro valor diferencial está en el juicio crítico. En saber cuándo una respuesta es brillante pero falsa; cuándo una búsqueda parece suficiente, pero deja fuera estudios clave; cuándo una herramienta promete evidencia y en realidad entrega una mezcla de resúmenes, sesgos y referencias fantasma; cuándo un documento está muy bien escrito, pero metodológicamente no se sostiene.
Ahí las bibliotecarias de ciencias de la salud tenemos un papel muy claro: somos árbitras de la realidad. Y sé que suena un poco solemne, pero en este momento hace falta cierta solemnidad. Porque estamos entrando en una etapa en la que producir texto será facilísimo, producir apariencia de conocimiento será baratísimo y distinguir lo fiable de lo dudoso será cada vez más difícil.
Hay además un problema de escala. La IA permite producir contenidos a una velocidad muy superior a nuestra capacidad humana para revisarlos. Y no, la solución no puede ser simplemente poner otra IA a validar lo que la primera IA ha generado, porque precisamente lo que está en juego es la confianza en ese proceso. Una herramienta puede ayudar a detectar errores o priorizar revisiones, pero no puede asumir la responsabilidad de decidir qué aceptamos como evidencia.
Ese desfase entre producción automática y validación humana es uno de los grandes desafíos que vienen. Y ahí las bibliotecas de ciencias de la salud tienen un papel incómodo pero imprescindible: recordar que más contenido no significa más conocimiento, y que una respuesta generada en segundos puede necesitar mucho más que segundos para ser considerada fiable.
Por eso, en este contexto, la biblioteca no puede limitarse a enseñar “herramientas de IA”. Tiene que enseñar a pensar con IA, contra la IA cuando haga falta, y más allá de la IA siempre.
La metáfora: una fábrica de respuestas
Para explicarlo de forma gráfica, he utilizado esta imagen: un hospital del futuro convertido casi en una fábrica de conocimiento asistida por inteligencia artificial. La IA produce en cadena artículos, guías clínicas, informes, resúmenes, referencias y recomendaciones con una apariencia impecable. Todo parece rápido, limpio, eficiente y profesional. Pero algunos de esos productos llevan señales de alerta: sesgo, evidencia débil, fuente no verificada, referencia fantasma, riesgo de alucinación.
La IA puede producir respuestas a gran velocidad; la biblioteca garantiza que esas respuestas sean fiables, trazables, éticas y útiles para la toma de decisiones en salud.
En primer plano aparece una bibliotecaria de ciencias de la salud revisando esos productos como si fuera una inspectora de control de calidad. No está compitiendo con la máquina en velocidad. No pretende producir más documentos que la IA. Su función es otra: comprobar la trazabilidad, evaluar la calidad metodológica, detectar errores, valorar la aplicabilidad clínica, revisar la evidencia y decidir qué puede considerarse fiable.
La metáfora es sencilla: la inteligencia artificial puede ser una fábrica de respuestas; las bibliotecarias somos el control de calidad del conocimiento. Y en salud, esto no es una cuestión estética ni corporativa. Una respuesta rápida pero falsa no es innovación: es riesgo con buena presentación.
La inteligencia artificial puede ser una fábrica de respuestas; las bibliotecarias somos el control de calidad del conocimiento.
También aportamos ética profesional. La IA no tiene deontología. No defiende la privacidad del usuario. No se preocupa por la equidad en el acceso. No se pregunta si una herramienta discrimina, si sus datos de entrenamiento son representativos, si sus resultados son transparentes o si está trasladando al usuario una falsa sensación de certeza. Nosotras sí deberíamos hacerlo.
Y, además, deberíamos estar en las mesas donde se decide qué herramientas se compran, cómo se implantan, con qué garantías, con qué límites y con qué evaluación. La incorporación de IA en instituciones sanitarias y académicas no debería ser solo una decisión tecnológica o comercial. También es una decisión ética, informacional y metodológica.
Investigación: la búsqueda no es apretar un botón
En investigación, nuestro valor es todavía más evidente. En una revisión sistemática, la IA puede ayudar en el cribado, en la extracción o en la organización de información, pero no sustituye la arquitectura intelectual de una búsqueda reproducible, sensible, transparente y justificable.
Traducir una pregunta clínica compleja en una estrategia de búsqueda no es apretar un botón: es tomar decisiones metodológicas, documentarlas y responder por ellas. Y eso, aunque a veces se olvide, es conocimiento experto.
Clínica: medicina inteligente, decisiones humanas
En clínica, el reto será parecido. La medicina se dirige hacia modelos cada vez más basados en datos, sistemas de apoyo a la decisión, algoritmos predictivos y herramientas integradas en la historia clínica. Pero la consigna debería seguir siendo muy sencilla: medicina inteligente, decisiones humanas.
Y en esa cadena de decisiones humanas, la biblioteca puede aportar algo esencial: evidencia validada, contexto, trazabilidad y prudencia.
La mediación humana también cuenta
Luego está el componente humano, que conviene no romantizar, pero tampoco despreciar. La IA puede contestar; una bibliotecaria puede acompañar. Puede entender que detrás de una pregunta hay una tesis bloqueada, un residente perdido, una enfermera preparando una sesión, un clínico con una duda real o un paciente asustado.
Esa mediación humana, esa capacidad de traducir complejidad sin aplastar a quien pregunta, no es un adorno: es parte del servicio.
La advertencia: la IA también genera sobrecarga
Ahora bien, quiero añadir una advertencia. Me preocupa que se nos pida ser líderes en IA con la misma plantilla, el mismo tiempo, el mismo presupuesto y, si puede ser, con una sonrisa.
Hay mucho discurso épico sobre la adaptación, pero poca conversación sobre la sobrecarga. La IA está generando nuevas tareas: formación, evaluación de herramientas, guías de uso, apoyo a investigadores, dudas docentes, problemas éticos, privacidad, derechos de autor, sesgos, integridad científica. Todo eso no se sostiene solo con vocación.
La vocación es magnífica, pero no debería ser el nombre elegante de trabajar siempre por encima de nuestras posibilidades.
Así que mi respuesta sería: lo que la IA no puede sustituir es nuestro juicio profesional, nuestra responsabilidad ética, nuestra capacidad de mediación, nuestra comprensión del contexto institucional y nuestra función como garantes de confianza. Pero para ejercer ese papel necesitamos algo más que entusiasmo tecnológico. Necesitamos reconocimiento, formación, tiempo, estructura y presencia estratégica.
Porque si la institución quiere que la biblioteca sea el “humano confiable en el bucle”, tendrá que dejar de tratarnos como el enchufe múltiple al que se conecta todo lo que nadie sabe dónde poner.
La IA no nos sustituirá por saber más que nosotras; nos sustituirán las instituciones si aceptan que una respuesta rápida vale más que una respuesta fiable.
Qué es un protocolo, qué decisiones debe preespecificar, dónde puede registrarse o depositarse y qué errores metodológicos conviene evitar.
Esta entrada recoge y desarrolla algunas de las ideas centrales del curso “Protocolo de revisiones sistemáticas: del protocolo como trámite al protocolo como garantía metodológica”, impartido recientemente para BiblioSalud. El material docente de la sesión está depositado en acceso abierto en Zenodo: Campos-Asensio C. Protocolo de revisiones sistemáticas: Del protocolo como trámite al protocolo como garantía metodológica. Zenodo; 2026 May 20. doi:10.5281/zenodo.20307930.
Un protocolo de revisión sistemática no es un requisito burocrático; es el mapa de navegación metodológico que blinda la integridad de la investigación, garantizando la transparencia y previniendo sesgos desde el primer paso.
Sin protocolo, la revisión puede parecer más rápida al principio, pero suele ser menos transparente, menos reproducible y más vulnerable a decisiones improvisadas.
El protocolo es un instrumento esencial para proteger la integridad del proceso de síntesis. Actúa como un mapa de navegación que fija el rumbo antes de que el «ruido» de los datos individuales o los resultados preliminares influyan en las decisiones del equipo. Al establecer una hoja de ruta clara y pública, el protocolo protege la síntesis de pruebas científicas, asegurando que los hallazgos finales sean fiables, creíbles y, por encima de todo, reproducibles por la comunidad científica internacional.
2. ¿Qué es un protocolo de revisión sistemática?
Un protocolo de revisión sistemática es un plan establecido a priori que describe de forma exhaustiva los objetivos, la metodología y el plan de análisis previstos. Según los estándares de la Colaboración Cochrane, no es un borrador flexible, sino un compromiso metodológico que permite a los lectores evaluar la rigurosidad de los métodos aplicados y verificar si existieron cambios injustificados durante la ejecución.
Definición de protocolo de revisión sistemática. El protocolo como plan a priori de una revisión sistemática.
Para ilustrar su aplicación, consideremos el ejemplo clásico del uso de vitamina C para el resfriado común. Un protocolo sólido definiría, antes de comenzar la búsqueda, los siguientes elementos nucleares:
Justificación y racionalidad: Descripción de la condición (fisiopatología del resfriado), la importancia de la intervención (vitamina C) y las lagunas de conocimiento actuales.
Pregunta de investigación y objetivos (Formato PICO/PECO): Por ejemplo: «¿Previene o trata la vitamina C el resfriado común en comparación con el placebo en adultos?». Aquí se definen la Población (adultos), Intervención (vitamina C oral), Comparación (placebo) y Outcomes o resultados (incidencia, duración y gravedad de los síntomas).
Criterios de elegibilidad: Definición precisa de qué estudios se incluirán (ej. ensayos clínicos aleatorizados) y cuáles se excluirán (ej. estudios en niños o que usen suplementos combinados).
Métodos de búsqueda, selección y extracción: Detalle de las fuentes (PubMed, Embase, Cochrane Library), la estrategia de búsqueda completa para al menos una base de datos y el proceso de cribado por duplicado e independiente.
Evaluación de sesgos: Plan para aplicar herramientas específicas como RoB 2 (para ensayos aleatorizados) o ROBINS-I (para estudios no aleatorizados).
Plan de síntesis de pruebas: Especificación de cómo se combinarán los datos. Esto incluye decidir si se realizará un metaanálisis o si se utilizarán otros métodos como la Síntesis sin Metaanálisis (SWiM) si la heterogeneidad es excesiva.
Mapa metodológico del protocolo de una revisión sistemática.
En esencia, la transparencia y la reproducibilidad son los pilares de esta definición, permitiendo que la comunidad científica confíe en la objetividad de las conclusiones.
3. Por qué el protocolo es el mejor aliado del equipo de revisión: 5 pilares prácticos
El desarrollo de un protocolo sólido no debe verse como una carga, sino como una inversión estratégica que se apoya en cinco pilares fundamentales:
3.1. Planificación y mitigación de la deriva
Una revisión sistemática implica muchas decisiones metodológicas: población, intervención o fenómeno de interés, comparadores, desenlaces, diseños de estudio, bases de datos, estrategia de búsqueda, proceso de cribado, extracción de datos, evaluación del riesgo de sesgo y método de síntesis.
El protocolo obliga al equipo a fijar la pregunta y los métodos antes de que el conocimiento de los resultados individuales pueda sesgar el juicio evitando que el equipo «improvise» criterios de selección a medida que encuentra estudios interesantes.
3.2. Transparencia y trazabilidad
Funciona como un rastro verificable de las decisiones. Al declarar los métodos de antemano, se permite que otros investigadores evalúen la alineación entre lo planeado y lo ejecutado. Esto es vital para detectar el reporte selectivo de resultados, donde solo se publican aquellos hallazgos que resultaron estadísticamente significativos.
Principales funciones del protocolo como plan vivo de la revisión: planificación, transparencia, control de sesgos, eficiencia y reproducibilidad.
3.3. Control de sesgos y decisiones ad hoc
El protocolo reduce el riesgo de decisiones ad hoc tomadas después de conocer los resultados de los estudios. Por ejemplo, cambiar los criterios de elegibilidad, modificar desenlaces o alterar el análisis porque los resultados no son los esperados puede introducir sesgo y comprometer la credibilidad de la revisión.
3.4. Reproducibilidad científica
El protocolo ofrece el detalle suficiente para que otro equipo pueda evaluar la «brecha» entre lo previsto y lo realizado. Es decir, permite comparar lo planificado con lo finalmente realizado. Esto no significa que el protocolo sea inamovible. En una revisión pueden surgir problemas no previstos: una definición demasiado restrictiva, un tipo de estudio relevante que no se había considerado o dificultades prácticas en la búsqueda. Pero cualquier modificación debe quedar claramente documentada y justificada en la revisión final.
3.5. Eficiencia y coordinación de equipos
La planificación previa ahorra tiempo y recursos. Permite asignar roles específicos (investigador principal, estadístico, coordinador de búsqueda) y alinear al equipo multidisciplinar. Además, su registro público alerta a otros investigadores, evitando la duplicación de esfuerzos y reduciendo el desperdicio de recursos en la ciencia.
4. Decisiones críticas que deben quedar definidas (antes de empezar)
Componentes esenciales que deben quedar preespecificados en el protocolo de una revisión sistemática.
Para cumplir con los estándares, existen componentes que no pueden dejarse al azar. Es imperativo redactar estas secciones en tiempo futuro y utilizando la voz activa (ej. «dos revisores seleccionarán los estudios de forma independiente» en lugar de «los estudios serán seleccionados»).
Estrategia de búsqueda: Se deben listar todas las fuentes (bases de datos, registros de ensayos, literatura gris) y proporcionar el borrador de términos para la base de datos principal.
Estrategia de búsqueda de evidencia: componentes técnicos y garantías metodológicas.
Proceso de selección y cegamiento: Debe detallarse cómo se manejará el «cegamiento» entre revisores durante el cribado para asegurar la independencia. Es fundamental decidir cómo se resolverán los desacuerdos (ej. mediante un tercer revisor senior).
Evaluación del riesgo de sesgo: No basta con mencionar que se evaluará; se debe especificar la herramienta (RoB 2 o ROBINS-I) y el software de gestión de datos, como RevMan, que facilita la integración de estas evaluaciones en los gráficos de bosque (forest plots).
Plan de análisis y síntesis: Se debe definir cuándo es apropiado un metaanálisis basándose en la heterogeneidad clínica y estadística. Si no es posible, se debe haber pre-especificado un método de síntesis alternativo (SWiM) para evitar la elección arbitraria de métodos tras ver los datos.
5. El ecosistema de registro: ¿Dónde y cómo publicar el plan?
Aunque PROSPERO sigue siendo la referencia internacional más reconocida para revisiones sistemáticas con desenlaces relacionados con la salud, especialmente en revisiones de efectividad, diagnóstico, pronóstico o factores de riesgo, no todas las revisiones encajan en sus criterios. Por ejemplo, las scoping reviews requieren habitualmente otras alternativas.
El ecosistema actual incluye plataformas con funciones distintas. Algunas actúan como registros específicos de revisiones sistemáticas, como PROSPERO o INPLASY; otras son registros generales de investigación, como OSF Registries o Research Registry; y otras funcionan principalmente como repositorios o espacios de publicación y preservación del protocolo completo, como protocols.io o Figshare. También existen opciones vinculadas a marcos metodológicos concretos, como el entorno JBI, especialmente útil para equipos afiliados que trabajan con metodología del Joanna Briggs Institute.
Principales plataformas para registrar, publicar o depositar protocolos de revisiones sistemáticas. No todas cumplen la misma función ni son adecuadas para todos los tipos de revisión.
Además de los registros específicos como PROSPERO o INPLASY, OSF Registries ofrece una opción especialmente flexible para preregistrar distintos tipos de revisiones. En concreto, dispone del formulario “Generalized Systematic Review Registration”, que permite documentar protocolos de revisiones sistemáticas, revisiones de alcance, revisiones cualitativas, metaanálisis u otros diseños de síntesis que no siempre encajan en los criterios de plataformas más específicas.
Además de decidir dónde registrar o depositar el protocolo, una cuestión práctica frecuente es por dónde empezar a redactarlo. Las plantillas pueden ser muy útiles para estructurar el trabajo inicial, asegurar que no se omiten apartados metodológicos relevantes y facilitar la discusión dentro del equipo revisor. Pero hay que recordad que las plantillas ayudan a estructurar el protocolo, pero deben adaptarse al tipo de revisión, a la pregunta de investigación y a los estándares metodológicos aplicables.
Entre los recursos útiles para preparar protocolos de revisiones sistemáticas y revisiones de alcance se encuentran las siguientes plantillas y documentos de apoyo:
JBI scoping review protocol template. Plantilla de ejemplo básica para protocolos de revisiones de alcance siguiendo metodología JBI. https://pubmed.ncbi.nlm.nih.gov/35102103/
6. Errores frecuentes: Lo que debilita tu garantía metodológica
El protocolo solo funciona como garantía metodológica si se redacta antes de iniciar la revisión, si recoge decisiones suficientemente detalladas y si se mantiene trazable cuando el proyecto evoluciona. En la práctica, una parte importante de los problemas no procede de la ausencia absoluta de protocolo, sino de un uso incompleto, retrospectivo o meramente formal del mismo.
Uno de los errores más frecuentes es la redacción tardía del protocolo. Si el documento se elabora cuando el cribado ya ha comenzado, o cuando el equipo ya ha tomado decisiones relevantes sobre criterios de elegibilidad, desenlaces, fuentes de información o análisis, el protocolo pierde su función principal: prevenir decisiones condicionadas por los resultados encontrados. En ese caso, deja de ser una planificación prospectiva y se convierte en una reconstrucción posterior del método.
Errores metodológicos frecuentes en el uso del protocolo: redacción tardía, falso protocolo, desviaciones silenciosas y abandono del registro.
Otro problema habitual es confundir un registro mínimo con un protocolo metodológico completo. Registrar una revisión en PROSPERO, OSF u otra plataforma no equivale necesariamente a disponer de un protocolo sólido. El registro aporta visibilidad, fecha, trazabilidad y transparencia, pero el protocolo debe contener el detalle suficiente para guiar la revisión: pregunta, criterios de inclusión y exclusión, fuentes de información, estrategia de búsqueda, gestión de duplicados, proceso de selección, extracción de datos, evaluación crítica y plan de síntesis.
También son frecuentes las desviaciones silenciosas respecto al plan inicial. Durante una revisión pueden aparecer razones legítimas para modificar algún aspecto metodológico: redefinir un desenlace, ajustar criterios de elegibilidad, cambiar el enfoque de síntesis o decidir que el metaanálisis no es adecuado por la heterogeneidad de los estudios. El problema no es modificar el protocolo cuando existe una justificación metodológica clara; el problema es hacerlo sin documentarlo.
La literatura también ha descrito problemas relacionados con el propio registro de las revisiones: desconocimiento de la necesidad de registrar el protocolo, temor infundado a que otros grupos “roben” la idea, baja cobertura del registro en determinados tipos de síntesis y el fenómeno de los llamados “protocolos fantasma”, es decir, registros que no llegan a traducirse en una revisión publicada o cuyo estado no se actualiza adecuadamente. A ello se suma el abandono del registro cuando no se refleja el progreso, la publicación final o la interrupción del proyecto (8-9).
7.Conclusión
Un protocolo sólido es la frontera que separa una revisión sistemática que aporta pruebas científicas fiables de una que solo genera confusión y ruido estadístico. Invertir tiempo en la fase de diseño no es solo una buena práctica; es la garantía de que el esfuerzo del equipo se traducirá en conocimiento capaz de transformar la práctica clínica y mejorar la salud de los pacientes.
NOTA: Esta entrada forma parte de una reflexión metodológica derivada del curso impartido para BiblioSalud sobre protocolos de revisiones sistemáticas. La presentación y los materiales docentes asociados están disponibles en acceso abierto en Zenodo, con el objetivo de facilitar su consulta, reutilización y preservación.
Para cerrar la entrada, he preparado también un breve cuestionario interactivo para que quienes lo deseen puedan comprobar sus conocimientos sobre los protocolos de las revisiones sistemáticas.
Cuestionario final de autoevaluación. Una forma práctica de comprobar si han quedado claros los conceptos esenciales sobre el protocolo de una revisión sistemática.
Referencias Bibliográficas
Moher D, Shamseer L, Clarke M, Ghersi D, Liberati A, Petticrew M, et al. Preferred reporting items for systematic review and meta-analysis protocols (PRISMA-P) 2015 statement. Syst Rev. 2015;4:1.
Shamseer L, Moher D, Clarke M, Ghersi D, Liberati A, Petticrew M, et al. Preferred reporting items for systematic review and meta-analysis protocols (PRISMA-P) 2015: elaboration and explanation. BMJ. 2015;349:g7647.
Cumpston M, Lasserson T, Flemyng E, Page MJ. Chapter III: Reporting the review. In: Higgins JPT, Thomas J, Chandler J, Cumpston M, Li T, Page MJ, editors. Cochrane Handbook for Systematic Reviews of Interventions version 6.5. Cochrane; 2024.
Covidence. Protocol Development for Systematic Reviews: A practical guide. Veritas Health Innovation Ltd; 2024.
Page MJ, McKenzie JE, Bossuyt PM, Boutron I, Hoffmann TC, Mulrow CD, et al. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021;372:n71.
Campos Asensio C. Necesidad de protocolo en las revisiones de síntesis de evidencia y dónde registrarlo. Biblioboletín. 2022; Junio (13):9. https://hdl.handle.net/20.500.12530/54668
Campos-Asensio C. Protocolo de revisiones sistemáticas: Del protocolo como trámite al protocolo como garantía metodológica [Internet]. Zenodo; 2026 May 20. doi:10.5281/zenodo.20307930.
Tawfik GM, Giang HTN, Ghozy S, Altibi AMA, Kandil H, Le HH, et al. Protocol registration issues of systematic review and meta-analysis studies: a survey of global researchers. BMC Med Res Methodol. 2020 Aug 25;20(1):213. doi:10.1186/s12874-020-01094-9.
Nguyen PY, Kanukula R, McKenzie JE, Alqaidoom Z, Brennan SE, Haddaway NR, et al. Changing patterns in reporting and sharing of review data in systematic reviews with meta-analysis of the effects of interventions: cross sectional meta-research study. BMJ. 2022 Nov 22;379:e072428. doi:10.1136/bmj-2022-072428.
La inteligencia artificial ya forma parte del proceso de escritura científica. También en las revisiones sistemáticas. Y no se trata de discutir si debe utilizarse o no, porque ya se está utilizando, sino de abordar una cuestión mucho más relevante: quién responde de su uso en los manuscritos.
Imagen generada por Gemini.
.
Los autores: responsables, sin matices
La responsabilidad principal debe recaer en los autores. Son quienes firman el manuscrito y quienes deben garantizar su integridad.
Esto implica algo más que declarar el uso de IA. Implica verificar de forma crítica todo lo que la herramienta haya generado o modificado: desde el texto hasta las referencias o la interpretación de los resultados. La evidencia reciente es clara: el problema no es el uso de IA, sino su uso sin supervisión y sin transparencia.
Imagen generada por Gemini.
.
Los revisores por pares: detectores de problemas, no auditores
El papel del revisor es clave, pero tiene límites. Puede, y debe, identificar señales de alerta: referencias que no existen, texto excesivamente genérico, incoherencias entre métodos y resultados o interpretaciones poco consistentes. Pero no es realista ni adecuado convertir al revisor en el responsable de verificar el uso de IA en cada manuscrito.
Además, el propio proceso de revisión ya está sometido a una presión creciente. La comprobación de referencias, por ejemplo, es cada vez más compleja y consume tiempo, a menudo con barreras técnicas añadidas.
Pedir al revisor que asuma también el control del uso de IA es, sencillamente, trasladar el problema a quien tiene menos capacidad estructural para resolverlo.
Imagen generada por Gemini.
.
Las revistas: donde debe estar el control
Si la responsabilidad es de los autores, el control debe estar en las revistas. Son las editoriales las que pueden establecer reglas claras y aplicables:
exigir la declaración del uso de IA,
realizar un cribado editorial previo,
implementar herramientas de detección de problemas,
orientar a los revisores sobre cómo actuar ante sospechas.
Algunas ya lo están haciendo, incorporando políticas específicas y reforzando los controles previos a la revisión por pares.
Sin este nivel de control editorial, el sistema depende en exceso de la buena práctica individual y del esfuerzo voluntario de los revisores.
.
Una responsabilidad compartida
Imagen generada por Gemini.
.
La solución no pasa por repartir la responsabilidad sin criterio:
Autores: responsables del contenido y del uso de IA.
Revistas: responsables de las normas y los controles.
Revisores: responsables de detectar problemas y señalarlos.
.
BIBLIOGRAFÍA
Begagić E, Skenderi F, Vranic S. The role of reviewers in the era of systematic reviews and meta-analysis: A practical guide for researchers. Biomol Biomed. 2026;26(1):40-50. https://doi.org/10.17305/bb.2025.12979
Mondal H. Letter regarding “The role of reviewers in the era of systematic reviews and meta-analysis: A practical guide for researchers”. Biomol Biomed. 2026. https://doi.org/10.17305/bb.2026.14264
La tesis es clara: la implantación acelerada de herramientas de IA generativa está añadiendo nuevas tareas, nuevas expectativas y nuevas presiones sobre el personal bibliotecario. Formación, acompañamiento, criterios de uso, resolución de dudas, elaboración de materiales, apoyo a docentes e investigadores… Todo ello, muchas veces, sobre estructuras ya tensionadas.
El artículo recupera además el concepto de idealización vocacional (conocido en la literatura anglosajona como vocational awe) y su intersección con la inteligencia artificial en el ámbito bibliotecario, útil para pensar cómo en bibliotecas a veces se normaliza asumir más responsabilidades en nombre del servicio, la adaptación o la misión profesional.
Porque la transformación digital no se sostiene solo con herramientas, se sostiene con personas. La IA no debe ser una frontera más que el bibliotecario deba conquistar mediante el sacrificio individual.
Y si las instituciones quieren una integración responsable de la IA, no basta con pedir liderazgo al personal bibliotecario: hace falta tiempo, apoyo, formación, reconocimiento y una estructura real de acompañamiento.
Una lectura muy recomendable para bibliotecarios, responsables académicos y gestores que quieran pensar la IA no solo como innovación, sino también como cambio organizativo con impacto humano.
Cuando hablamos de revisiones sistemáticas, solemos pensar en búsquedas en múltiples bases de datos bibliográficas con estrategias booleanas extensas y complejas. Pero tenemos que recordar que una parte de la evidencia relevante no siempre llega a las revistas científicas o no lo hace con la misma rapidez ni visibilidad. Ahí es donde entra la literatura gris. Tesis, informes técnicos, registros de ensayos, resúmenes de congresos o documentos regulatorios pueden aportar información valiosa para reducir sesgos, completar el mapa de la evidencia y mejorar la transparencia del proceso de revisión. Buscarla no siempre es sencillo, pero ignorarla sin justificación puede debilitar una síntesis.
Empecemos por lo básico: qué entendemos por literatura gris
La literatura gris suele definirse como aquella producción científica o técnica generada por instituciones académicas, administraciones, organismos, empresas o industrias que no está controlada por los circuitos editoriales comerciales habituales (1). Una de las características que mejor define a la literatura gris es, precisamente, su dificultad de localización. En primer lugar porque queda fuera de los circuitos convencionales de indexación, búsqueda y difusión científica. Además, a menudo está dispersa, mal descrita, alojada en plataformas heterogéneas o en sitios web poco estables, lo que obliga a diseñar estrategias de búsqueda más abiertas, más manuales y mejor documentadas.
¿Y qué entra dentro de este grupo? Tenemos, entre otros, las tesis doctorales, los informes técnicos, la documentación de agencias reguladoras, las actas o resúmenes de congresos, los registros de ensayos clínicos y los preprints.
Resulta llamativo que, pese a la importancia metodológica de rastrear literatura gris, algunos manuscritos de revisiones sistemáticas sigan indicando como motivo de exclusión que un estudio no haya sido publicado en una revista con revisión por pares, como si el canal de publicación pudiera sustituir por sí mismo la valoración crítica de su relevancia y su calidad metodológica.
Por qué importa en una revisión sistemática
La principal razón para buscar literatura gris es metodológica. Su inclusión puede ayudar a reducir el sesgo de publicación, es decir, la tendencia a que los estudios con resultados positivos o estadísticamente significativos tengan más probabilidades de publicarse en revistas que aquellos con resultados nulos o negativos (1).
Esto tiene consecuencias directas en la síntesis de la evidencia. Si una revisión incorpora solo estudios publicados en revistas, puede ofrecer una imagen incompleta o sesgada del efecto real de una intervención; dejar fuera determinadas fuentes puede afectar a la estimación final (2). Un ejemplo es el que Man-Son-Hing y cols. encontraron del uso de la quinina para calambres nocturnos: los ensayos publicados reportaron estimaciones de eficacia aproximadamente un 50% mayores que los documentos de la FDA (3). En otro caso, varias revisiones sistemáticas de estudios publicados informaron que la agomelatina era un tratamiento eficaz para la depresión, pero no se demostró ningún efecto del tratamiento cuando se incluyeron siete estudios no publicados. Otros ejemplos de sesgo de publicación incluyen oseltamivir para la influenza en adultos, estatinas para la prevención de eventos tromboembólicos venosos y reboxetina para la depresión (4).
Además, también es especialmente útil para identificar datos de seguridad y eventos adversos que en ocasiones quedan menos desarrollados en los artículos de revista y solo se encuentra en documentos no publicados o regulatorios (5).
Y por último, otra razón importante es que permite detectar estudios en curso o nunca publicados.
Motivo
Explicación
Reducir el sesgo de publicación
– Evitar o minimizar el sesgo de publicación; – Contrarrestar visiones incompletas de la evidencia (p. ej., salud cerebral, deterioro de la función renal); – Abordar el efecto cajón (file drawer effect), en el que los resultados negativos permanecen sin publicar.
Mejorar la exhaustividad
– Garantizar la recuperación de todos los estudios elegibles, incluidos los no publicados y no indexados; – Incrementar la generalizabilidad, la exhaustividad y el tamaño muestral; – Integrar fuentes publicadas y no publicadas para construir una base de evidencia más completa.
Acceso a estudios no publicados o en curso
– Identificar tesis doctorales, disertaciones, informes técnicos, informes gubernamentales y actas de congresos; – Localizar ensayos no publicados o en curso mediante registros; – Localizar investigación temprana o en desarrollo aún no publicada en revistas revisadas por pares.
Evidencia del mundo real y específica del contexto
– Incluir evidencia procedente de la práctica clínica habitual (p. ej., efectividad vacunal postcomercialización, experiencias en fisioterapia, teletrabajo durante la COVID-19); – Incorporar perspectivas diversas más allá de los ensayos clínicos, incluyendo enfoques organizativos y gubernamentales; – Identificar marcos, modelos y lagunas en políticas nacionales (p. ej., entorno escolar canadiense, teoría del confort de Kolcaba).
Ampliación del alcance y mapeo conceptual
– Mapear de forma completa modelos conceptuales, marcos y estrategias; – Aportar complejidad situacional y diversidad de perspectivas (p. ej., revisiones de alcance con enfoque iterativo); – Captar definiciones y estrategias que no siempre son visibles en la literatura revisada por pares.
Modificada y traducida de: Khalil H., Johns-Hayden A., Kynoch K. Guidance to including grey literature in systematic reviews-recommendations from an epidemiological study. Journal of Clinical Epidemiology. 2026:112222, doi: 10.1016/j.jclinepi.2026.112222.
Cuándo puede ser especialmente relevante
En áreas con fuerte presencia de la industria, como ensayos con fármacos o dispositivos, porque los intereses comerciales pueden influir en qué resultados llegan a publicarse y cuáles no. También en tecnologías sanitarias emergentes, donde la evidencia puede aparecer antes en informes técnicos, documentos de agencias o preprints que en revistas indexadas.
Resulta igualmente relevante en revisiones sobre políticas públicas, programas o implementación, donde parte de la información útil procede de organismos oficiales, instituciones o documentos técnicos. Y en temas con escasa literatura publicada, los resúmenes de congresos, tesis y otras fuentes no convencionales pueden aportar estudios o datos que ayuden a completar el panorama.
Qué fuentes conviene tener en cuenta
Entre las fuentes más relevantes en salud destacan los registros de ensayos clínicos, como ClinicalTrials.gov o la plataforma de registros de la OMS, útiles para localizar estudios terminados no publicados y, a veces, resultados disponibles directamente en el registro.
También son importantes las tesis y disertaciones, que pueden contener información más extensa que la finalmente publicada en artículos; los resúmenes y actas de congresos, especialmente valiosos en áreas muy dinámicas, aunque con limitaciones por la brevedad de la información; los informes técnicos e institucionales, incluidas evaluaciones de tecnologías sanitarias y documentos regulatorios; y los repositorios de preprints, cada vez más relevantes en determinadas áreas. A esto se suman motores y directorios como Google Scholar, BASE, OpenDOAR, ROAR o recursos especializados de literatura gris, aunque con diferentes prestaciones, coberturas y limitaciones (6).
Tipos de fuentes de literatura gris útiles para revisiones sistemáticas. (Nota: OpenGrey fue discontinuado en 2020 y hoy permanece como archivo).
Categoría
Recomendaciones
Fuentes principales a considerar siempre
– Google Scholar: amplia cobertura de literatura académica y gris, pero requiere un cribado cuidadoso debido a su baja precisión; – ProQuest: especialmente útil para tesis y disertaciones; – ClinicalTrials.gov: esencial para identificar datos de ensayos clínicos no publicados; – OpenGrey: específicamente dedicado a literatura gris (aunque actualmente archivado, sigue siendo útil a través de repositorios).
Fuentes complementarias según el tema de la revisión
– Los sitios web de organizaciones y la consulta a expertos son especialmente importantes en áreas con fuerte componente de políticas o práctica (p. ej., salud pública, educación, servicios sociales); – La búsqueda manual de actas de congresos, sitios web institucionales y materiales no indexados sigue siendo crucial cuando se espera que estas fuentes aporten evidencia relevante.
Bases de datos bibliográficas especializadas
– Scopus, PsycINFO y Web of Science pueden recuperar fuentes “semigrises” (por ejemplo, resúmenes de congresos y actas) y deben considerarse cuando sean pertinentes para la revisión.
Motores de búsqueda web generales
– Google (búsqueda general) puede recuperar documentos únicos de carácter institucional o local, pero no debe utilizarse como única estrategia; – Se recomienda el uso de búsquedas estructuradas y el registro de URL y fechas para garantizar la reproducibilidad.
Recomendaciones para la selección de bases de datos para literatura gris. Modificada y traducida de: Khalil H., Johns-Hayden A., Kynoch K. Guidance to including grey literature in systematic reviews-recommendations from an epidemiological study. Journal of Clinical Epidemiology. 2026:112222, doi: 10.1016/j.jclinepi.2026.112222.
La evidencia disponible muestra que herramientas como Google Scholar son útiles para recuperar literatura gris, pero no deben utilizarse como única fuente, ya que pueden omitir estudios relevantes y presentan limitaciones de precisión y transparencia (7).
Dificultades metodológicas de la búsqueda de literatura gris
Buscar literatura gris es posible y muchas veces necesario, pero rara vez es tan limpio, estandarizado o replicable como buscar en una base de datos bibliográfica tradicional.
No existe un único estándar de referencia y muchas de estas fuentes carecen de lenguaje controlado, interfaces potentes o posibilidades de exportación comparables a las de bases como MEDLINE o Embase. Esto obliga a trabajar más con términos en lenguaje natural, incrementa el ruido en la recuperación y dificulta tanto la reproducibilidad como la documentación. Además, muchos contenidos web cambian, desaparecen o se actualizan sin dejar rastro claro, lo que complica la trazabilidad. En algunos entornos, como Google Scholar, la falta de transparencia en el algoritmo de ordenación añade una dificultad extra (7).
Errores frecuentes
Uno de los errores más habituales es declarar de forma genérica que se buscó “en Google” o “en literatura gris” sin especificar qué fuentes concretas se consultaron, con qué estrategia, en qué fecha y con qué límites. Otro error frecuente es asumir que la literatura gris tiene menor calidad por definición. Su calidad metodológica debe valorarse con los mismos principios y, cuando proceda, con herramientas específicas que cualquier otro estudio o documento.
También es problemático no conservar evidencia documental de determinadas búsquedas o no registrar metadatos básicos como la URL, la fecha de consulta o la estrategia utilizada. En fuentes inestables, esto puede dificultar comprobaciones posteriores.
Cómo plantear una búsqueda de literatura gris
La búsqueda de literatura gris debe planificarse desde el protocolo, no añadirse al final como un gesto de exhaustividad formal. Conviene decidir desde el principio qué tipos de fuentes son pertinentes para la pregunta de investigación, cuáles son asumibles en términos de tiempo y recursos y cómo se va a documentar el proceso.
Esto implica seleccionar de forma justificada las fuentes, adaptar la estrategia a cada interfaz, registrar fechas, URLs, términos utilizados y límites aplicados, y seguir marcos de transparencia como PRISMA-S (8). También puede incluir el contacto con autores cuando se sospecha la existencia de estudios no publicados o información complementaria relevante.
En motores como Google Scholar, además, es importante asumir desde el principio que la búsqueda tiene limitaciones técnicas y que el procedimiento debe quedar claramente descrito.
Conviene identificar y mantener claramente separados los datos procedentes de literatura gris y los de estudios publicados en revistas por razones de transparencia metodológica. Esta distinción permite saber qué parte de la evidencia procede de circuitos editoriales convencionales y cuál se ha recuperado a través de registros, informes, tesis, resúmenes de congresos u otras fuentes no comerciales, facilitando la trazabilidad del proceso y la interpretación de los resultados. Además, separar ambas procedencias hace posible realizar análisis de sensibilidad y valorar hasta qué punto la inclusión de literatura gris modifica las estimaciones del efecto, los datos de seguridad o las conclusiones de la revisión.
Conclusión
La literatura gris no es un añadido accesorio ni una garantía automática de calidad. Es, sobre todo, una fuente potencialmente útil para mejorar la exhaustividad, reducir determinados sesgos y captar evidencia que no siempre circula por las vías editoriales habituales. Su búsqueda plantea dificultades y no siempre deberá hacerse con la misma exhaustividad en todas las revisiones. Pero prescindir de ella sin una justificación razonada puede dejar fuera una parte relevante de la evidencia y debilitar la solidez de la síntesis final.
BIBLIOGRAFÍA
Hopewell S, McDonald S, Clarke MJ, Egger M. Grey literature in meta-analyses of randomized trials of health care interventions. Cochrane Database Syst Rev. 2007;(2):MR000010.
McAuley L, Pham B, Tugwell P, Moher D. Does the inclusion of grey literature influence estimates of intervention effectiveness reported in meta-analyses? Lancet. 2000;356(9237):1228-31. doi:10.1016/S0140-6736(00)02786-0.
Man-Son-Hing M, Wells G, Lau A. Quinine for nocturnal leg cramps: a meta-analysis including unpublished data. J Gen Intern Med. 1998;13(9):600-6. doi: 10.1046/j.1525-1497.1998.00182.x.
Ziai H., Zhang R., Chan A-W., Persaud N. Search for unpublished data by systematic reviewers: an audit. BMJ Open. 2017;7(10):e017737, doi: 10.1136/bmjopen-2017-017737.
Golder S, Loke YK, Wright K, Norman G. Reporting of adverse events in published and unpublished studies of health care interventions: a systematic review. PLoS Med. 2016;13(9):e1002127. doi:10.1371/journal.pmed.1002127.
Khalil H, Johns-Hayden A, Kynoch K. Guidance to including grey literature in systematic reviews: recommendations from an epidemiological study. J Clin Epidemiol. 2026:112222, doi: 10.1016/j.jclinepi.2026.112222.
Haddaway NR, Collins AM, Coughlin D, Kirk S. The Role of Google Scholar in Evidence Reviews and Its Applicability to Grey Literature Searching. PLoS One. 2015;10(9):e0138237. doi: 10.1371/journal.pone.0138237.
Rethlefsen ML, Kirtley S, Waffenschmidt S, Ayala AP, Moher D, Page MJ, et al. PRISMA-S: an extension to the PRISMA Statement for Reporting Literature Searches in Systematic Reviews. J Med Libr Assoc. 2021;109(2):174-200.
Una de las preguntas que más se repiten hoy entre autores no es si pueden usar inteligencia artificial, sino para qué pueden usarla y cuando no deberían. La respuesta seria no cabe en un sí o en un no. No existe una autorización general para “usar IA” en un artículo. Lo que existe es un marco cada vez más aceptado: autoría humana, responsabilidad humana, transparencia cuando el uso es sustantivo y restricciones claras en ámbitos especialmente sensibles como imágenes, datos, confidencialidad y revisión por pares.
El framework interactivo de Lluís Codina (https://www.perplexity.ai/apps/9d81f4a2-97e6-4854-9443-d259f4ff3a01) resulta útil precisamente porque ordena ese terreno, aunque el propio autor recuerda que es una herramienta orientativa y que la norma aplicable en cada caso sigue siendo la de la revista, la editorial, la institución o el programa académico correspondiente.
Primera línea roja: autoría, responsabilidad y declaración de uso
La IA no puede figurar como autora. No puede asumir responsabilidad por el trabajo, no puede responder por la integridad del contenido y no puede aprobar la versión final del manuscrito. Esa responsabilidad sigue recayendo por completo en las personas firmantes. Dicho de otro modo: la IA puede ser una herramienta, pero no un sujeto autoral.
¿Y cuál si es un uso aceptado sin declaración formal? La corrección ortográfica, gramatical o de estilo, siempre que no impliquen generación sustantiva de contenido y que el autor revise críticamente el resultado. En ese mismo espacio se sitúan los gestores bibliográficos y herramientas equivalentes de apoyo, que ayudan a organizar referencias pero no producen por sí mismas el contenido intelectual del artículo.
El problema empieza cuando la IA deja de pulir la forma y empieza a influir de manera sustantiva en el contenido. Si se utiliza para reescribir apartados completos, estructurar borradores, resumir literatura de forma sustantiva, identificar lagunas, formular objetivos o hipótesis, interpretar análisis o intervenir de forma significativa en el proceso de investigación, el uso debe declararse con transparencia. Las recomendaciones europeas insisten en que, cuando la herramienta influye de manera significativa, debe explicarse qué herramienta se ha usado, con qué versión, para qué propósito y de qué modo ha afectado al proceso. Algunas editoriales piden además una declaración específica en el manuscrito; Elsevier, por ejemplo, la sitúa antes de las referencias, mientras que en otros entornos esa información puede ir en Métodos o en Agradecimientos.
Aquí conviene aclarar que declarar el uso de IA no convierte automáticamente ese uso en admisible. Hay intervenciones que muchas políticas editoriales restringen o directamente no permiten aunque el autor las reconozca. Es el caso de la creación o alteración de imágenes y figuras con IA generativa, salvo excepciones muy concretas en las que la IA forma parte del propio método de investigación y el proceso puede describirse de manera reproducible. También es una mala idea tratar la salida de un sistema generativo como si fuera texto original listo para integrarse sin más en el manuscrito. La IA puede inspirar, sugerir o ayudar a reformular, pero no sustituye la aportación intelectual auténtica del autor.
Segunda línea roja: integridad
Otra zona crítica es la integridad científica. Las directrices europeas son explícitas al señalar que no debe utilizarse IA para falsificar, alterar o manipular datos originales. Además, recuerdan que estos sistemas pueden producir sesgos, alucinaciones e incluso referencias inventadas, por lo que la verificación humana no es opcional, sino obligatoria. En realidad, el principio rector es bastante simple: cuanto más influye la herramienta en el contenido, más alta debe ser la exigencia de comprobación crítica.
Tercera línea roja: confidencialidad y propiedad intelectual
La confidencialidad y la propiedad intelectual merecen un apartado aparte. Subir a una herramienta externa un manuscrito inédito, datos sensibles, imágenes no publicadas, prompts con información protegida o materiales de terceros puede generar problemas serios de privacidad, reutilización no autorizada y pérdida de control sobre el contenido. Las recomendaciones europeas y varias editoriales insisten en revisar las condiciones de uso, comprobar si el contenido puede reutilizarse para entrenamiento y evitar la carga de materiales confidenciales en sistemas externos sin garantías adecuadas. Este punto es todavía más estricto en revisión por pares: tanto Springer Nature como Elsevier indican que los manuscritos sometidos a revisión no deben cargarse en herramientas generativas públicas por razones de confidencialidad, derechos de autor e integridad del proceso editorial.
Realizado por C. Campos Asensio con Google Gemini
Consejo práctico a los autores
Para un autor, una regla práctica útil sería esta. Si la herramienta solo mejora la expresión y no altera el contenido intelectual, probablemente estás en una zona relativamente segura. Si contribuye de forma sustantiva a redactar, organizar, interpretar o decidir, debes declararlo. Y si afecta a datos, imágenes, material inédito, confidencialidad o evaluación de trabajos ajenos, conviene detenerse y revisar con mucho cuidado la política de la revista antes de continuar. Es una cuestión de integridad, trazabilidad y responsabilidad académica.
Una fórmula razonable para muchos casos no es esconder el uso de IA ni convertirlo en un reclamo, sino describirlo con sobriedad cuando haya sido relevante: herramienta utilizada, finalidad concreta, grado de intervención y revisión humana posterior. La buena práctica consiste en mantener al autor dentro del proceso, con pensamiento crítico, control de la versión final y responsabilidad plena sobre cada afirmación, cada dato y cada referencia.
Bibliografía
Codina L. Cómo saber si un uso de la IA en trabajos académicos es legítimo: framework interactivo [desarrollado con Perplexity] [Internet]. 2026 Feb 13 [citado 18 mar 2026]. Disponible en: lluiscodina.com.
Codina L. Uso ético y eficiente de la inteligencia artificial en trabajos académicos: Veritas e interacción crítica escalonada. BiD. 2025;55. doi:10.1344/bid2025.55.01. Disponible en: https://www.raco.cat/index.php/BiD/article/view/980000003803.
Bhavsar D, Duffy L, Jo H, Lokker C, Haynes R, Iorio A, et al. Policies on artificial intelligence chatbots among academic publishers: a cross-sectional audit. Res Integr Peer Rev. 2025;10:1. doi:10.1186/s41073-025-00158-y. Disponible en: https://link.springer.com/article/10.1186/s41073-025-00158-y
Los estándares metodológicos coinciden en una idea central: la búsqueda debe ser sistemática, planificada y lo más amplia posible para reducir sesgos (especialmente sesgo de publicación y de reporte) y capturar la mayor parte de la evidencia relevante (1). A diferencia de una revisión tradicional donde un autor puede elegir artículos de su preferencia («handpicking»), una búsqueda exhaustiva busca identificar toda la evidencia disponible que responda a una pregunta de investigación específica para evitar el sesgo de selección. En una anterior entrada ya hemos analizado cómo podemos saber si nuestra búsqueda es exhaustiva. Ahora veamos lo que realmente significa “exhaustividad” (comprehensiveness).
Exhaustividad no equivale a “hacer una búsqueda larga” ni a “meter muchas palabras”. Es diseñar un proceso que aspire a identificar el conjunto más completo y no sesgado posible de estudios pertinentes para una pregunta predefinida. En el Manual Cochrane (1) lo expresa de forma directa: la búsqueda debe ser tan extensa como sea posible para reducir el riesgo de sesgo de reporte/publicación e identificar la mayor cantidad de evidencia relevante.
¿Significa esto que hay que usar absolutamente todos los métodos imaginables?, no, es decidir (y justificar) cómo lograr un conjunto de evidencia completo y no sesgado con los recursos disponibles.
3 pilares de la exhaustividad: cobertura, sensibilidad y trazabilidad
Si una búsqueda no es exhaustiva y documentada en detalle, la evidencia resultante no se considera válida ni fiable para la toma de decisiones clínicas. Es, de hecho, el factor principal que distingue a una revisión sistemática de cualquier otro tipo de revisión bibliográfica.
Analicemos los tres pilares de la exhaustividad:
1. Cobertura: no hay exhaustividad con una sola fuente
Una revisión que busca “toda la evidencia” pero consulta una única base (p. ej., solo PubMed) es vulnerable por definición: indexación incompleta, diferencias en tesauros, retrasos de indización, sesgos geográficos/idiomáticos, etc. La evidencia empírica lo respalda: en un estudio sobre revisiones Cochrane, buscar en ≥2 bases de datos aumentó cobertura/recall y redujo el riesgo de perder estudios elegibles; y cuando se sospecha que los artículos son difíciles de localizar, deben añadirse métodos suplementarios (2).
Y, desde la perspectiva de combinaciones “óptimas”, Bramer et al. observaron que varias referencias incluidas solo aparecen en una base de datos y propusieron como combinación mínima eficiente (dependiente del tema) incluir, al menos, Embase, MEDLINE, Web of Science y Google Scholar para maximizar recall (3).
Bien es verdad que no existe un número universal de bases de datos. Lo que exigen los estándares es justificar por qué esas fuentes son las adecuadas para tu pregunta y tu campo. Cochrane (1), por ejemplo, establece como mínimo para sus revisiones la consulta de CENTRAL, MEDLINE y Embase, además de fuentes especializadas según el tema.
2. Sensibilidad: maximizar recall sin perder el control
La búsqueda exhaustiva prioriza sensibilidad (recall) frente a precisión (precision), aceptando que habrá ruido. El Manual Cochrane (1) lo formula explícitamente: hay que maximizar sensibilidad procurando una precisión razonable; aumentar sensibilidad suele bajar precisión y recuperar más irrelevantes. En este punto hay que afirmar que ruido no significa mala búsqueda; puede significar que se ha protegido la revisión contra la omisión de estudios relevantes.
3. Trazabilidad: exhaustividad sin documentación no existe
Una búsqueda “muy buena” pero no reproducible es metodológicamente débil. PRISMA 2020 (4) exige describir todas las fuentes consultadas (bases, registros, webs, listas de referencias, etc.) y la fecha de última consulta. Además, pide presentar las estrategias completas (línea a línea) para todas las bases/registros/webs, con límites y filtros, para permitir evaluación de la exhaustividad, replicación y actualización.
PRISMA-S (2021) va un paso más allá con una lista específica (16 ítems) para reportar búsquedas de forma completa y reproducible (5).
¿Cuáles son los componentes de una búsqueda exhaustiva?
A. Múltiples bases y fuentes
Una búsqueda exhaustiva combina:
Bases bibliográficas generales y especializadas (según tema). Se recomienda realizar búsquedas en un rango de 3 a 5 bases de datos bibliográficas académicas relevantes para el área de estudio (por ejemplo, MEDLINE, EMBASE, CINAHL o Scopus).
Registros de ensayos y repositorios de resultados cuando aplica (p. ej., ClinicalTrials.gov, ICTRP).
Literatura gris. Incluye investigaciones que no han sido publicadas en revistas comerciales tradicionales (como tesis, informes técnicos o actas de conferencias). Omitir la literatura gris puede introducir un sesgo significativo, ya que a menudo los estudios con resultados negativos o neutrales no llegan a publicarse en revistas de alto impacto (sesgo de reporte).
Búsqueda web (agencias reguladoras, organizaciones, etc.).
B. Vocabulario controlado + texto libre (y traducción entre plataformas)
Hay que usar tanto texto libre como encabezamientos (MeSH, Emtree, etc.) y personalizar y adaptar las estrategias por cada base. Además, recuerda que MeSH≠Emtree, la indización difiere y para ser lo más exhaustivo posible hay que incorporar un rango amplio de sinónimos, variantes ortográficas, truncamientos y operadores de proximidad.
Siempre recordando que “traducir la estrategia”no es copiar/pegar; es conservar el concepto y adaptar la sintaxis y el comportamiento del buscador (campos, explosión, proximidad, stopwords, mapeo automático).
C. Técnicas adicionales
La propia lógica metodológica es simple: ninguna base indexa “todo” y la evidencia muestra que métodos suplementarios pueden añadir estudios que el searching en bases no recupera. Para cerrar el círculo de la exhaustividad, se deben emplear métodos como la «búsqueda manual» (handsearching) y el «encadenamiento de citas» (citation chaining), que consiste en revisar las referencias de los artículos encontrados para localizar estudios adicionales que las bases de datos pudieron omitir.
D. Control de calidad: revisión por pares de la estrategia (PRESS)
El estándar PRESS (6) formaliza la revisión por pares de estrategias electrónicas y define elementos típicos donde aparecen errores (operadores booleanos/proximidad, encabezamientos, texto libre, límites/filtros, sintaxis, etc.). PRISMA 2020 incluso sugiere reportar si hubo peer review y qué herramienta se utilizó (p. ej., PRESS).
Errores frecuentes que “rompen” la exhaustividad
Una sola base (o varias, pero sin complementariedad).
No combinar tesauro + texto libre, o no adaptar la estrategia a cada base.
Límites no justificados (idioma/fecha/tipo de documento) aplicados en la búsqueda, no como criterio de selección. PRISMA pide que los límites se reporten y se justifiquen en relación con criterios de elegibilidad.
Omitir literatura gris/registros cuando el riesgo de sesgo de publicación es material.
No informar de las estrategias completas (solo “buscamos en PubMed y Embase”): impide evaluar calidad, reproducir y actualizar.
BIBLIOGRAFÍA
Lefebvre C, Glanville J, Briscoe S, Featherstone R, Littlewood A, Metzendorf M-I, Noel-Storr A, Paynter R, Rader T, Thomas J, Wieland LS. Chapter 4: Searching for and selecting studies [last updated March 2025]. En: Higgins JP, Thomas J, Chandler J, Cumpston M, Li T, Page MJ, et al, editor(s). Cochrane Handbook for Systematic Reviews of Interventions version 6.5.1 Cochrane, 2025.Disponible en: cochrane.org/handbook.
Ewald H., Klerings I., Wagner G., Heise TL., Stratil JM., Lhachimi SK., et al. Searching two or more databases decreased the risk of missing relevant studies: a metaresearch study. Journal of Clinical Epidemiology. 2022;149:154-64, doi: 10.1016/j.jclinepi.2022.05.022.
Bramer WM, Rethlefsen ML, Kleijnen J, Franco OH. Optimal database combinations for literature searches in systematic reviews: a prospective exploratory study. Syst Rev. 2017 Dec 6;6(1):245. doi: 10.1186/s13643-017-0644-y.
Page MJ, Moher D, Bossuyt PM, Boutron I, Hoffmann TC, Mulrow CD, Shamseer L, Tetzlaff JM, Akl EA, Brennan SE, Chou R, Glanville J, Grimshaw JM, Hróbjartsson A, Lalu MM, Li T, Loder EW, Mayo-Wilson E, McDonald S, McGuinness LA, Stewart LA, Thomas J, Tricco AC, Welch VA, Whiting P, McKenzie JE. PRISMA 2020 explanation and elaboration: updated guidance and exemplars for reporting systematic reviews. BMJ. 2021 Mar 29;372:n160. doi: 10.1136/bmj.n160.
Rethlefsen ML, Kirtley S, Waffenschmidt S, Ayala AP, Moher D, Page MJ, Koffel JB; PRISMA-S Group. PRISMA-S: an extension to the PRISMA Statement for Reporting Literature Searches in Systematic Reviews. Syst Rev. 2021 Jan 26;10(1):39. doi: 10.1186/s13643-020-01542-z.
McGowan J, Sampson M, Salzwedel DM, Cogo E, Foerster V, Lefebvre C. PRESS Peer Review of Electronic Search Strategies: 2015 Guideline Statement. J Clin Epidemiol. 2016 Jul;75:40-6. doi: 10.1016/j.jclinepi.2016.01.021.
Dos artículos publicadas en JAMA (Research Letters) aportan datos observacionales reales procedentes de los propios sistemas de envío de manuscritos, donde las revistas empezaron a preguntar de forma obligatoria por el uso de IA. El resultado es que la IA se está utilizando, pero se declara en una minoría de envíos. Y, cuando se declara, la mayoría de usos tiene que ver con la escritura y edición del texto.
Perlis y cols. describen los resultados de un estudio transversal de todos los manuscritos enviados a 13 revistas de la red JAMA entre el 29 de agosto de 2023 (después de que se agregaron preguntas sobre el uso de la IA al proceso de envío) y el 31 de octubre de 2025.3 Entre 105,538 manuscritos enviados durante los 27 meses del estudio, 3,459 (3.3%) declararon el uso de IA. Pero el dato importante es la tendencia a lo largo del periodo estudiado (27 meses): aumentó significativamente durante este período, del 1.71% (IC del 95%, 1.27%-2.15%) al 5.97% (IC del 95%, 5.28%-6.66%).
El estudio de AlFayyad y cols. describe el uso reportado de IA entre los artículos de investigación enviados a revistas de BMJ. Los autores realizaron un estudio transversal de todos los manuscritos de investigación (incluidas revisiones sistemáticas y metanálisis) enviados entre el 8 de abril y el 6 de noviembre de 2024 a 49 revistas de BMJ. Entre 25.114 presentaciones elegibles, 1.431 (5,7%) informaron sobre el uso de IA. También aquí se observa incremento dentro del periodo: de 4,5% (abril 2024) a 7,3% (octubre 2024).
Estos trabajos son una “foto” útil del fenómeno: estas cifras son declaraciones, no “uso real” (probablemente hay infradeclaración) por omisión deliberada o por incertidumbre sobre qué debe declararse, y el uso crece.
La mayoría de los autores utilizaron IA para mejorar la escritura y refinar el lenguaje. El artículo realizado en las revistas JAMA indica que el motivo más frecuente es corrección o refinamiento del lenguaje (67,7%); seguido del desarrollo de modelos estadísticos (7,3%), otros análisis (6,3%), borrador/redacción (5,5%) y búsqueda/evaluación de literatura (4,3%). El 87,2% de quienes declararon IA en las revistas del grupo BMJ dijeron usarla para mejorar la calidad de la escritura.
Podemos concluir que la IA se está usando sobre todo como “asistente de escritura”, para escribir “bien” y rápido, especialmente en entornos donde el inglés no es lengua oficial. Y aunque los manuscritos con autor de correspondencia de un país sin inglés como idioma oficial tuvieron más probabilidad de declarar IA (OR 1,30) (Perlis RH) también puede influir que de autores con afiliación de Europa (OR 1,28 frente a Asia) y de Sudamérica (OR 1,75 frente a Asia) declaran más (AlFayyad I).
Es probable que la creciente disponibilidad de herramientas de IA generativa lleve a más investigadores a usar IA para tareas más avanzadas que generalmente se consideran aspectos clave del proceso científico impulsados por el intelecto, como resumir la literatura existente, analizar datos y redactar manuscritos.
Lo más relevante de estos trabajos no es el porcentaje exacto de hoy, sino la tendencia y su mensaje: la declaración sube y la IA se moverá (probablemente) desde tareas de escritura hacia tareas más avanzadas que generalmente se consideran aspectos clave del proceso científico impulsados por el intelecto, como resumir la literatura existente, analizar datos y redactar manuscritos. Eso obliga a una cultura científica donde la transparencia sea un estándar.
BIBLIOGRAFÍA
Perlis RH., Flanagin A., Kendall-Taylor J., Berkwits M., Bibbins-Domingo K. Author Disclosure of Use of AI in Submissions to 13 JAMA Network Journals. JAMA. 2026;335(8):717, doi: 10.1001/jama.2025.25300.
AlFayyad I., Zeegers MP., Bouter L., Macdonald H., Schroter S. Self-Disclosed Use of AI in Research Submissions to BMJ Journals. JAMA. 2026;335(8):719, doi: 10.1001/jama.2025.25688.
Malani PN., Ross JS. AI Use in Research and the Need for Continued Guidance. s. f., doi: 10.1001/jama.2025.26845.
En revisiones sistemáticas, trasladar la estrategia al resto de bases de datos es uno de los pasos más exigentes porque exige conocimiento experto de bases, plataformas y sintaxis. No es un trámite: forma parte del método y condiciona la sensibilidad y la reproducibilidad del proceso.
Dado que la búsqueda para revisiones sistemáticas debe ser sensible y no existe una única fuente que recoja de forma exhaustiva todo lo publicado, es necesario buscar en un número suficiente de bases de datos, seleccionadas según el objetivo (sensibilidad vs precisión), la cobertura temática y el tipo de evidencia. Cada base se interroga de manera distinta y devuelve conjuntos de documentos parcialmente diferentes. Además, aunque las plataformas permiten combinar texto libre, búsqueda por campos, tesauro y límites, cada una implementa estas funcionalidades con su propia “gramática” de búsqueda.
El problema real: al traducir entre bases también traducimos reglas
Cuando pasamos una estrategia de PubMed/MEDLINE a Embase (y a otras bases), los fallos suelen agruparse en tres categorías:
No adaptación de la estrategia. Copiar/pegar “tal cual” sin ajustar a la plataforma puede cambiar la recuperación (a veces sin que sea evidente): campos incorrectos, paréntesis interpretados de otra forma, comillas, límites no equivalentes o funciones que existen en una base y no en otra.
Diferencias en el lenguaje de búsqueda. Etiquetas de campo, comodines, gestión de frases y (muy especialmente) operadores de proximidad.
Errores en encabezamientos de materia. Cada base tiene su propio tesauro (MeSH, Emtree, CINAHL Headings, Thesaurus APA…), y no hay equivalencias 1:1 garantizadas.
Dónde encaja Polyglot y qué aporta de verdad
Polyglot Search Translator (TERA Tools) está diseñado para traducir cadenas de búsqueda entre bases y plataformas, ahorrando trabajo repetitivo y reduciendo errores de tecleo, sin sustituir el criterio experto. Un ensayo aleatorizado observó que traducir con Polyglot fue, en promedio, más rápido (31 vs 45 minutos) y con menos errores (8,6 vs 14,6) que la traducción manual, aunque sigue siendo imprescindible revisión humana (Clark JM, 2020)
Su valor es claro: un traductor de sintaxis que agilizael traslado entre plataformas, pero que funciona de verdad cuando se usa como lo que es: una semi-automatización con supervisión experta. Polyglot traduce cadenas desde PubMed u Ovid MEDLINE a múltiples plataformas para que tú te concentres en lo que no se puede automatizar como el tesauro o la proximidad.
Cómo usar Polyglot
Aquí te dejo las instrucciones de cómo sería el flujo de trabajo si queremos trasladar una estrategia que hemos hecho en PubMed a Embase:
1) Desarrolla y depura tu estrategia “base”.
Crea la estrategia en bloques conceptuales claros, con paréntesis cerrados y consistencia en campos y truncamientos.
En TERA, Polyglot ofrece un cuadro “Your query” donde pegar la cadena. Es recomendable marcar la casilla “Replace line references” (para que resuelva referencias del tipo #1, #2, etc.) y añadir una línea en blanco en la cadena para mejorar el procesamiento en algunos casos.
3) Elegir la salida correcta para Embase (Embase.com vs Ovid Embase)
Polyglot suele ofrecer traducciones diferenciadas para bases de datos y plataformas, en nuestro casa disponemos de las opciones de Embase.com (Elsevier) y Ovid Embase. Piensa que no son equivalentes: cambian campos, operadores y convenciones.
4) Verificación del vocabulario controlado (Emtree)
Este es el paso crítico:
Identifica los términos que en PubMed estaban como MeSH (p. ej., [Mesh] / explosiones) y valida su equivalente en Emtree.
Sustituye manualmente cuando no haya correspondencia directa o el término preferido difiera.
Polyglot te ahorra reescritura de sintaxis, pero no puede asumir equivalencias terminológicas sin supervisión.
5) Operadores de proximidad.
Aunque PubMed incorporó proximidad en 2022, con la sintaxis «términos»[Title:~N] o «términos»[Title/Abstract:~N], limitada a determinados campos, no puede considerarse una proximidad equivalente a la proximidad de otras plataformas (NEAR/NEXT o ADJ). Más bien es una ayuda para la búsqueda por frases.
Por eso, cuando trasladas desde PubMed, la traducción “literal” tal cual es proporcionada por Polyglot no aprovecha el potencial de la búsqueda por adyacencia de otras plataformas. Cuando migras desde PubMed a Embase, debes decidir (concepto a concepto) si las transformas en proximidad (más sensibilidad, riesgo de introducir ruido si el “n” es amplio) o mantienes la búsqueda por frases exactas (más precisión, riesgo de perder variantes).
No hay respuesta universal: depende del concepto, del objetivo de la búsqueda y del equilibrio sensibilidad/precisión. La única forma de hacerlo es probar, comparar y documentar el ajuste.
6) Ejecutar y comprobar
Antes de dar la traducción por válida revisa truncamientos, comillas y campos; ejecuta y comprueba si recuperas artículos semilla y si los recuentos son plausibles. Si un artículo relevante aparece en una base y no en otra, la pregunta útil no es “¿por qué no está?”, sino qué parte de la traducción no lo capturó: campos, fraseo, proximidad, tesauro o límites.
BIBLIOGRAFÍA
Clark JM, Sanders S, Carter M, Honeyman D, Cleo G, Auld Y, Booth D, Condron P, Dalais C, Bateup S, Linthwaite B, May N, Munn J, Ramsay L, Rickett K, Rutter C, Smith A, Sondergeld P, Wallin M, Jones M, Beller E. Improving the translation of search strategies using the Polyglot Search Translator: a randomized controlled trial. J Med Libr Assoc. 2020 Apr;108(2):195-207. doi: 10.5195/jmla.2020.834.
Imagina esto: después de meses de analizar y organizar datos, ya tienes lista tu revisión sistemática para enviarla. Pero, justo días antes de enviarla, te topas por casualidad con tres artículos clave que tu estrategia de búsqueda ni siquiera consideró y que cambian todo lo que pensabas. Es el miedo más grande de cualquier bibliotecario: no saber si realmente has encontrado todo lo que hay.
Y es que cuando trabajamos en síntesis de evidencia, la «intuición» del experto o la simple acumulación de años de experiencia no son salvaguardas suficientes. Y por eso es tan necesario la validación de la sensibilidad de la búsqueda de evidencia que transforma una recopilación bibliográfica convencional en un proceso científico reproducible y defendible ante cualquier auditoría metodológica.
Este interesante artículo de Lagisz et al, recientemente publicado, nos da unas pautas de actuación para evaluar la sensibilidad de las estrategias de búsqueda. Analicemos este artículo y su propuesta.
«Recall absoluto» y «recall relativo»
En revisiones sistemáticas se prioriza típicamente «alto «recall» (minimizar pérdida de estudios relevantes), aceptando un descenso de precisión que luego se gestiona con cribado. En el ámbito de la recuperación de información, es teóricamente imposible garantizar un «recall absoluto». Esto se debe a que el universo total de la literatura existente es, por definición, desconocido; no podemos medir lo que no sabemos que existe. Para resolver esta incertidumbre, debemos adoptar el concepto pragmático de «recall relativo« (o sensibilidad).
Cálculo del recall absoluto. Recall (en español, exhaustividad o sensibilidad) es la proporción de documentos relevantes que un sistema consigue recuperar del total de documentos relevantes que existen en la colección para una necesidad de información dada.
Bajo este enfoque, evaluamos nuestra estrategia frente a una muestra representativa y conocida de estudios. Esto nos permite sustituir la subjetividad por una métrica objetiva de rendimiento, optimizando el balance entre la exhaustividad y la manejabilidad de los resultados.
El corazón del proceso es el set de referencia o artículos «semilla«. Un error metodológico crítico es el sesgo circular: diseñar la estrategia de búsqueda y luego seleccionar para el set de validación artículos que esa misma cadena ya encontró. Esto no es más que un sesgo de Confirmación que «engaña» al cálculo con artículos homogéneos, invalidando la prueba de estrés de la estrategia.
Para que este set actúe como un verdadero «estándar de oro», debe ser externo y recolectado mediante mejores prácticas:
• Recolección Temprana: El set debe reunirse estrictamente antes de diseñar la estrategia de búsqueda definitiva.
• Fuentes Diversas: Debe incluir revisiones sistemáticas previas, rastreo de citas (backward/forward tracking), etc.
• Revisión por Expertos: Consulta con especialistas en el área temática para garantizar la representatividad de autores y años.
• Heterogeneidad: Debe reflejar la variedad de terminología y términos controlados del tema para evitar la homogeneidad simplista.
6 Etapas del flujo de trabajo del bibliotecario
Para validar nuestra búsqueda, Lagisz et al., nos sugieren seguir este flujo de trabajo secuencial:
Recolección del set de evaluación comparativa («benchmarking»): Define el alcance y reúne los estudios que sean útiles que encuentres, ya sea hablando con expertos o buscando en otras fuentes.
Búsqueda de identificadores: Localiza los DOI de cada estudio y combínalos con el operador OR para crear una «cadena de benchmarking» compacta. Si un estudio no aparece por DOI, debe buscarse por título o autor para verificar si la ausencia es real.
Personalización del set: Verifica cuáles estudios están indexados en la base de datos actual. Debemos eliminar los estudios no indexados del cálculo para no penalizar injustamente el puntaje de sensibilidad (unfairly lowering the sensitivity score).
Ejecución de la búsqueda objetivo: Aplica tú estrategia de búsqueda completa (MeSH, Emtree, palabras clave y lógica booleana) y registra el número total de resultados (hits).
Prueba de solapamiento: Cruza ambas cadenas mediante el operador AND en un bloque lógico simple: [Cadena de Búsqueda Objetivo] AND [Cadena del set de evaluación comparativa].
Cálculo de sensibilidad: Aplica la fórmula para obtener el «recall relativo» y determina si el resultado inicia un ciclo de mejora.
Cálculo e Interpretación
En una revisión sistemática, buscamos una sensibilidad alta, pero esto suele aumentar el «ruido» (resultados irrelevantes). No existe un umbral universal del 100% por lo que el equipo de revisión debe decidir cuándo la búsqueda es «suficientemente buena».
Fórmula de sensibilidad (recall):
Sensibilidad = (Estudios del set encontrados) / (Total de estudios del set indexados en la base de datos)
Ejemplo práctico: Si su set de referencia consta de 5 artículos indexados en Scopus y su cadena objetivo captura 4 de ellos:
Cálculo: 4 / 5 = 0.8
Resultado: 80% de sensibilidad.
Interpretación: El 20% de la literatura clave es «invisible« para su búsqueda actual, lo que exige una justificación técnica de si ese nivel de riesgo es aceptable o requiere refinamiento.
¿Qué pasa si la sensibilidad es baja?
Si este es nuestro caso, debemos realizar un análisis diagnóstico de los estudios «no capturados» siguiendo esta lista de tareaspara el Refinamiento:
Aislar omisiones: Ejecutar Cadena de Benchmarking NOT Cadena de Búsqueda Objetivo para visualizar exclusivamente los artículos que su estrategia ignoró.
Análisis de registros: Examinar los campos de título, resumen y términos controlados (encabezamientos de materia) de los estudios perdidos.
Ajuste de lógica: Incorporar sinónimos detectados o flexibilice los operadores de proximidad y truncamiento.
Justificación Técnica: Documentar la justificación razonada detrás de cada término añadido para mantener la trazabilidad.
Revalidación: Repetir el cálculo de sensibilidad hasta alcanzar el equilibrio deseado por el equipo de revisión. Este refinamiento garantiza que la búsqueda final sea un reflejo fiel del estado del arte, cumpliendo con los estándares de transparencia internacional.
Bibliografía
Lagisz M, Yang Y, Young S, Nakagawa S. A practical guide to evaluating sensitivity of literature search strings for systematic reviews using relative recall. Res Synth Methods. 2025 Jan;16(1):1-14. doi: 10.1017/rsm.2024.6.
La ciencia «zombi» que amenaza la práctica clínica
Ya hablamos de «revisiones zombies» en BiblioGetafe, es decir, aquellas cuyos registros de protocolo están abandonados. Ahora hablamos de otros tipos de muertos vivientes: «los artículos zombi» que amenazan la práctica clínica.
La ciencia tiene un mecanismo de autocorrección que es necesario pero no perfecto: la retractación. Cuando se detecta un error grande, una mala práctica o un fraude en un artículo publicado, la revista emite una retractación y el trabajo queda oficialmente “retirado”. Sin embargo, muchos de estos artículos siguen circulando. Continúan siendo citados y aparecen en búsquedas, como si nada hubiera pasado. Es como una ciencia zombi: información que debería estar fuera de circulación, pero que sigue influyendo en el debate científico.
Estudios retractados que se cuelan en revisiones sistemáticas.
El problema se agrava cuando estos estudios se incluyen en revisiones sistemáticas y guías de práctica clínica. Si un estudio retirado se incluye en una revisión, puede contaminar las estimaciones de efecto, alterar las conclusiones y, en última instancia, distorsionar las recomendaciones clínicas y las decisiones de política sanitaria.
Poniendo cifras al problema
Un estudio publicado en JAMA Internal Medicine titulado “Inclusion of Retracted Studies in Systematic Reviews and Meta-Analyses of Interventions” y liderado por Graña Possamai C. (1) analizó hasta qué punto los estudios retractados consiguen infiltrarse en revisiones sistemáticas y metaanálisis, y qué ocurre cuando se eliminan de los cálculos. El equipo partió de un enfoque pragmático: utilizó una herramienta online para localizar revisiones sistemáticas publicadas en 25 de las revistas médicas de mayor impacto que citaban una o más “referencias problemáticas”. Después, verificaron manualmente cuáles de esas referencias eran retractaciones y repitieron los metaanálisis excluyendo los estudios retractados para observar cambios en estimaciones de efecto y en la interpretación de los resultados.
Los hallazgos son difíciles de ignorar:
En total, se identificaron 61 revisiones sistemáticas con metaanálisis que habían incluido al menos un estudio retractado; de ellas, solo 11 fueron posteriormente republicadas, retractadas o retiradas, quedando 50 para el análisis principal.
Esas 50 revisiones sistemáticas incluían 62 estudios retractados (58 de ellos llegaron a entrar en al menos un metaanálisis).
La causa predominante de retractación estuvo relacionada con problemas de datos / integridad de los datos.
En 13 revisiones, el estudio problemático ya estaba retractado antes de que la propia revisión se publicara: una señal clara de fallo en la verificación de los estudios durante la búsqueda y selección.
En conjunto, dentro de esas 50 revisiones, 173 metaanálisis incorporaban al menos un estudio retractado.
¿La inclusión de estos estudios retractados altera realmente las conclusiones de la evidencia?
La pregunta clave es si la inclusión de estudios retractados altera realmente lo que concluimos a partir de la evidencia. Y la respuesta del estudio es clara. Cuando los autores repitieron los metaanálisis excluyendo los artículos retractados, la significación estadística cambió en 18 metaanálisis: 15 pasaron de “significativo” a “no significativo”, pero 3 cambiaron en sentido contrario (de “no” a “sí”). Este tipo de giro, sobre todo cuando se pierde significación, puede tener consecuencias directas en cómo se interpreta la utilidad de una intervención.
Ahora bien, el editorial que acompaña al artículo apunta algo aún más interesante: el problema no es solo “si funciona”, sino cuánto parece funcionar. En los 64 metaanálisis que evaluaban resultados primarios, la presencia de estudios retractados modificó la magnitud del efecto de forma nada despreciable: ≥10% en 27 (42%), ≥30% en 16 (25%) y ≥50% en 12 (19%).
No es un problema marginal: se identificaron 50 revisiones que incluían 62 estudios retractados, con 173 metaanálisis afectados. No solo cambia el “sí/no”: al excluir retractados, la significación estadística cambió en 18 metaanálisis (en 15 se perdió la significación).
Y hay un detalle con implicaciones clínicas: esas variaciones en la magnitud del efecto a menudo se desplazaban a favor de la intervención, es decir, podían inflar artificialmente su aparente eficacia.
Si algo deja este análisis es una idea incómoda pero útil: un estudio retractado no siempre “rompe” la conclusión, pero puede empujarla lo suficiente como para cambiar la percepción del beneficio… y con ello, la decisión.
Solución compartida y cómo detectarlo
La solución no recae sobre un único actor: es una responsabilidad compartida, todos los agentes implicados tienen un papel que desempeñar para reducir el impacto de la evidencia retractada en la síntesis.
Los autores de revisiones deben de verificar “estatus de retractación”. Esto no es siempre fácil dado que el estado de retractación no siempre es evidente en las bases de datos bibliográficas.
Aquí es donde tiene sentido apoyarse en recursos externos y de vigilancia (2), por ejemplo: Retraction Watch Database (https://retractionwatch.com/), Problematic Paper Screener específicamente su detector «Feet of Clay» (https://dbrech.irit.fr/pls/apex/f?p=9999%3A31) y la revisión post-publicación en PubPeer (https://pubpeer.com). Otra posibilidad es aprovechar las funciones de notificación de retractaciones integradas en herramientas como Zotero o EndNote, que se alimentan de la base de datos de Retraction Watch.
Es igualmente recomendable que los autores realicen una nueva evaluación de los estudios incluidos justo antes de la publicación definitiva de la revisión para detectar cambios de estatus recientes.
Otras posibilidades sería que los autores creasen alertas automáticas en las bases de datos que les notificaran de aquellos artículos que han citado cuando este es retractado.
Las guías metodológicas de síntesis de evidencia deben recomendar formalmente la “detección de retractaciones” con estrategias específicas; así se podría incluir en las listas de verificación PRISMA (3). A nivel de postpublicación, si un estudio incluido en una revisión es retractado después de su publicación, las revistas deben añadir correcciones o notificar a los lectores y, cuando sea factible, recomendar realizar unreanálisis del metaanálisis excluyendo el estudio retractado para evaluar si los resultados y las conclusiones se mantienen (3).
La prevención es posible: verificación sistemática + herramientas de alerta + mejor señalización editorial.
Por último, herramientas de cribado especializadas como Covidence o Rayyan podrían incluir una funcionalidad para asegurar que el estatus de retractación sea reconocible.
Hacia una evidencia más robusta y fiable
El crecimiento sostenido de las retractaciones, que superó el umbral récord de 10.000 en 2023 (4), es un desafío directo para la integridad de la evidencia científica. La parte más preocupante no es la retractación en sí, sino su “vida posterior”, es decir, artículos que deberían quedar fuera del corpus siguen circulando, se citan, se reanalizan y pueden acabar contaminando revisiones sistemáticas, metaanálisis y, por extensión, guías de práctica clínica.
Es una responsabilidad compartida de investigadores, editores, plataformas y también de los bibliotecarios que sostenemos los flujos de búsqueda, verificación y síntesis de la evidencia el mitigar este problema. Hay que ir más allá con soluciones y asumiendo que «retractado» no significa automáticamente «inofensivo».
Bibliografía
Grana Possamai C, Cabanac G, Perrodeau E, Ghosn L, Ravaud P, Boutron I. Inclusion of Retracted Studies in Systematic Reviews and Meta-Analyses of Interventions: A Systematic Review and Meta-Analysis. JAMA Internal Medicine. 2025;185(6):702-9, doi: 10.1001/jamainternmed.2025.0256.
Gross CP., Flanagin A., Perencevich EN., Inouye SK. Mitigating the Impact of Retracted Studies in the Medical Literature. JAMA Intern Med. 2025;185(6):621, doi: 10.1001/jamainternmed.2025.0251.
Bakker C, Boughton S, Faggion CM, Fanelli D, Kaiser K, Schneider J. Reducing the residue of retractions in evidence synthesis: ways to minimise inappropriate citation and use of retracted data. BMJ Evid Based Med. 2024 Mar 21;29(2):121-126. doi: 10.1136/bmjebm-2022-111921.
Van Noorden R. More than 10,000 research papers were retracted in 2023 – a new record. Nature. 2023 Dec;624(7992):479-481. doi: 10.1038/d41586-023-03974-8.
Preguntas frecuentes
¿Cómo saber si un artículo está retractado? Comprueba el estatus en la base de datos donde lo localizaste (p. ej., registros con etiqueta de retractación) y contrástalo con recursos externos de vigilancia.
¿Qué pasa si un estudio retractado entra en un metaanálisis? Puede cambiar la significación de resultados y, sobre todo, alterar la magnitud del efecto (el “cuánto funciona”), con impacto potencial en conclusiones y recomendaciones.
¿Qué herramientas ayudan a detectar retractaciones durante una revisión? Útiles en la práctica: Retraction Watch, Problematic Paper Screener, PubPeer y alertas/avisos en gestores de referencias como Zotero (si el registro está identificado de forma compatible).
¿Basta con que el artículo esté retractado para “desactivarlo”? No. El problema es la “vida posterior”: puede seguir citándose, entrar en síntesis y permanecer en resúmenes si no se verifica y corrige “aguas abajo”.
¿Qué pueden hacer las revistas/editoriales para reducir el daño? Señalización inequívoca del estatus, metadatos coherentes y prácticas consistentes de comunicación de retractaciones (para que se vean claramente en cualquier buscador/basedatos).
PRISMA 2020 declara explícitamente que no es para guiar la conducción de la revisión ni para evaluar calidad metodológica.
¿Puedo citar PRISMA 2020 como metodología? No, es una guía de reporte (y por qué importa)
Muchos investigadores confunden realizar una revisión sistemática con reportarla. Piensan que completar un checklist al final es un “seguro de calidad”, pero PRISMA 2020 no funciona así: no es un trámite de última hora, sino un estándar para hacer transparente lo que se hizo y lo que se encontró.
El Gran Malentendido: reporte vs. metodología
En artículos es frecuente leer “seguimos PRISMA” como si describiera cómo se ejecutó la revisión. El problema es conceptual: PRISMA 2020 es una guía de reporte, no una guía metodológica para “hacer” revisiones. De hecho, PRISMA 2020 declara explícitamente que no pretende guiar la conducción de la revisión ni evaluar su calidad metodológica. Esta confusión alimenta malas prácticas (y revisiones “bien contadas” pero débilmente ejecutadas).
La Declaración PRISMA 2020 no es un trámite burocrático de última hora; es un cambio de paradigma hacia la transparencia total.
Analogía culinaria
La Metodología es la «receta»: El procedimiento detallado (Cochrane, JBI) sobre cómo se diseña y ejecuta la revisión.
PRISMA son los «ingredientes»: La información mínima que debe mostrar la revisión sistemática que permite a otros entender, evaluar y reproducir tu trabajo.
Una revisión puede “cumplir PRISMA” y aun así ser metodológicamente débil si el diseño y la ejecución fueron inadecuados.
Un reporte que cumpla todos los ítems de PRISMA puede seguir siendo «metodológicamente incomestible» si el diseño original es sesgado.
Qué es PRISMA y qué incluye (componentes):
PRISMA (Preferred Reporting Items for Systematic Reviews and Meta-Analyses)es una guía para informar/reportar/comunicar una revisión sistemática, pero NO es una recomendación de cómo hacer una revisión sistemática.
PRISMA 2020 incluye, entre otros componentes:
Checklist de 27 ítems.
Diagramas de flujo (plantillas para revisiones originales y actualizaciones).
Documento de Explanation & Elaboration con explicación y ejemplos por ítem.
Extensiones (PRISMA for Abstracts; PRISMA for Acupuncture; PRISMA for Chinese Herbal Medicines; PRISMA for Complex Interventions; PRISMA-COSMIN for Outcome Measurement Instruments; PRISMA for Diagnostic Test Accuracy; PRISMA for EcoEvo; PRISMA Equity; PRISMA Harms; PRISMA Individual Participant Data; PRISMA for Living Systematic Reviews; PRISMA Moxibustion; PRISMA for Network Meta-Analyses; PRISMA for Protocols; PRISMA for Scoping Reviews; PRISMA Search)
Reducir “cajas negras”: obliga a explicitar elementos que antes se omitían (p. ej., estrategias completas, herramientas, disponibilidad de datos/código).
Aumentar transparencia: deja rastro de decisiones clave (fuentes, selección, extracción, síntesis).
Mejorar reproducibilidad: facilita replicar/actualizar la revisión, incluida la búsqueda.
Facilitar evaluación crítica: permite a editores y lectores valorar lo que se hizo y sus limitaciones.
Uso recomendado: no “rellenar casillas” al final, sino usar PRISMA como mapa de documentación desde el protocolo.
Qué NO es PRISMA 2020
PRISMA 2020 no es:
Una guía para diseñar y ejecutar la revisión (eso corresponde a manuales metodológicos y a un protocolo).
Un sello de calidad metodológica: cumplir ítems no elimina sesgos ni garantiza una síntesis apropiada.
Un instrumento de riesgo de sesgo (RoB 2, ROBINS-I, QUADAS-2, etc.).
Cómo usar PRISMA 2020 bien
Desde el protocolo: define pregunta, criterios, outcomes, comparadores y plan de síntesis a priori (para protocolos, PRISMA-P).
Selección trazable: quién cribó, cómo se resolvieron discrepancias y diagrama PRISMA.
Herramientas/automatización: si se usaron, describir cuáles y cómo afectaron decisiones.
No confundir reporte con validación: además del checklist, riesgo de sesgo y certeza de la evidencia.
Aclaración técnica para el diagrama de flujo PRISMA 2020
Para que los números “cuadren”, hay que dominar la jerarquía terminológica:
Record (registro): título/resumen indexado.
Report (documento): el “contenedor” (artículo, preprint, tesis, registro, etc.).
Study (estudio): la investigación; puede tener múltiples reports.
Además, el ítem 16b exige citar los estudios que “podrían parecer elegibles” y explicar por qué se excluyeron tras texto completo.
Malas utilizaciones frecuentes
Decir seguimos PRISMA como sinónimo de metodología;
Completar el checklist al final como ‘sello de calidad’:
Diagrama de flujo que no cuadra (por no distinguir record/report/study);
No reportar estrategias completas (o solo una);
No explicar exclusiones a texto completo (ítem 16b).
¿Es PRISMA la única guía de reporte?NO
¿Y entonces, qué guías metodológicas debo seguir para mi revisión?
En la tabla vemos los consorcios internacionales y organizaciones nacionales que proporcionan guías metodológicas para el desarrollo de síntesis de evidencia.
En resumen: ¿Puedo citar PRISMA como metodología para mi revisión?La respuesta es no: PRISMA (incluido PRISMA 2020) es una guía de reporte, no un manual metodológico para diseñar y ejecutar una revisión. Del mismo modo, PRISMA-ScR proporciona criterios para reportar una revisión de alcance, no instrucciones para llevarla a cabo.
PRISMA no garantiza calidad por sí solo, pero sí garantiza algo imprescindible: que otros puedan ver con claridad qué hiciste, juzgarlo y reproducirlo.
No solo facilita la labor editorial; también protege la calidad y la confianza del conocimiento que, en última instancia, impactará en la práctica clínica y en los pacientes.
PRISMA no te dice cómo hacerlo bien; te obliga a enseñar qué hiciste. Y esa diferencia es la frontera entre transparencia y apariencia.
Bibliografía
Page MJ, McKenzie JE, Bossuyt PM, Boutron I, Hoffmann TC, Mulrow CD, Shamseer L, Tetzlaff JM, Akl EA, Brennan SE, Chou R, Glanville J, Grimshaw JM, Hróbjartsson A, Lalu MM, Li T, Loder EW, Mayo-Wilson E, McDonald S, McGuinness LA, Stewart LA, Thomas J, Tricco AC, Welch VA, Whiting P, Moher D. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021 Mar 29;372:n71. doi: 10.1136/bmj.n71.
Page MJ, Moher D, Bossuyt PM, Boutron I, Hoffmann TC, Mulrow CD, et al. PRISMA 2020 explanation and elaboration: updated guidance and exemplars for reporting systematic reviews. BMJ. 2021;372:n160. doi:10.1136/bmj.n160.
Sarkis-Onofre R, Catalá-López F, Aromataris E, Lockwood C. How to properly use the PRISMA Statement. Syst Rev. 2021;10(1):117. doi:10.1186/s13643-021-01671-z.
Rethlefsen ML, Kirtley S, Waffenschmidt S, Ayala AP, Moher D, Page MJ, et al; PRISMA-S Group. PRISMA-S: an extension to the PRISMA Statement for Reporting Literature Searches in Systematic Reviews. Syst Rev. 2021;10:39. doi:10.1186/s13643-020-01542-z.
EQUATOR Network. PRISMA: an updated guideline for reporting systematic reviews.
Kolaski K, Logan LR, Ioannidis JPA. Guidance to Best Tools and Practices for Systematic Reviews. JBJS Rev. 2023 Jun 7;11(6):e23.00077. doi: 10.2106/JBJS.RVW.23.00077.
Acaba de publicarse en Journal of Evidence-Based Medicine el artículo “Umbrella Reviews: Concepts, Methodological Frameworks, and Step-by-Step Implementation” (Liu et al., 2025; doi:10.1111/jebm.70092), de acceso abierto. Es una lectura muy recomendable y complementaria al trabajo de Belbasis et al. en BMJ Medicine (“Conducting umbrella reviews”, 2022).
¿Por qué surgen las revisiones paraguas?
Vivimos en una era de sobrecarga informativa. A diario se publican estudios con resultados y conclusiones en ocasiones contradictorias, lo que complica responder a una pregunta aparentemente simple: ¿qué sabemos con suficiente certeza? Este desafío no afecta solo al público general; clínicos, gestores y responsables de políticas sanitarias se enfrentan a un crecimiento sostenido de la literatura científica.
El fenómeno no se limita a la investigación primaria. Tal y como advirtió Ioannidis, asistimos también a una auténtica «expansión»epidemia» de la literatura secundaria (revisiones sistemáticas y metaanálisis). Cuando se acumulan múltiples revisiones sobre temas cercanos (o incluso la misma pregunta), el problema deja de ser “encontrar evidencia” para convertirse en identificar, comparar y valorar críticamente cuál de esa evidencia es más fiable y aplicable. Para ponerlo en perspectiva, la base de datos médica PubMed ha indexado más de 510,000 revisiones sistemáticas y metaanálisis.
La evidencia secundaria crece… y con ella el reto de interpretarla con rigor.
En este contexto, las revisiones paraguas (umbrella reviews) aportan una solución metodológica para introducir orden. A diferencia de una revisión sistemática clásica, una umbrella review no analiza directamente estudios primarios; su unidad de análisis son revisiones sistemáticas (RS) y metaanálisis (MA) ya publicados. Como Belbasis et al. señaló, las revisiones paraguas ofrecen una visión general de múltiples intervenciones para una condición médica específica o múltiples asociaciones epidemiológicas para una condición médica específica (enfoque de exposición amplia) o un factor de riesgo específico (enfoque de fenómeno amplio).
En términos conceptuales, hablamos de investigación terciaria:
La investigación primaria genera datos (p. ej., ensayos clínicos, cohortes).
La investigación secundaria sintetiza por primera vez esos datos (RS/MA).
La investigación terciaria integra y evalúa críticamente múltiples síntesis secundarias (overviews y umbrella reviews).
Por ello, en la jerarquía de la evidencia, las revisiones paraguas se sitúan en un nivel alto de síntesis, especialmente útiles para ofrecer una visión global y comparativa del estado del conocimiento y apoyar decisiones clínicas, de gestión o de salud pública.
¿Cuándo debemos hacer una revisión paraguas?
La idea central es sencilla: cuando el “nivel alto” de evidencia (SR/MA) se multiplica, necesitamos metodologías de síntesis terciaria que permita:
integrar resultados de varias revisiones,
comparar conclusiones entre sí,
valorar críticamente su calidad metodológica y la certeza del cuerpo de evidencia,
y identificar qué conclusiones son más sólidas y dónde persisten incertidumbres.
Belbasis y cols. propusieron, además, un algoritmo de decisión práctico para orientar cuándo es preferible una umbrella review frente a otros tipos de síntesis.
Características de las revisiones paraguas
Las revisiones paraguas se distinguen por varios rasgos nucleares:
Unidad de análisis: revisiones sistemáticas con o sin metaanálisis (no estudios primarios).
Alcance: suelen abordar campos amplios (por ejemplo, varias intervenciones para una misma condición, o múltiples asociaciones exposición–resultado).
Propósito: ofrecer una visión panorámica (“bird’s-eye view”), gestionar la sobrecarga de evidencia y ayudar a resolver discrepancias entre revisiones.
Utilidad estratégica: facilitan la toma de decisiones al permitir comparar varias alternativas (intervenciones, enfoques, asociaciones) en un único documento; son un insumo valioso para guías y políticas.
Evaluación crítica: no se limitan a resumir resultados; incorporan una valoración estructurada de la calidad metodológica y del riesgo de sesgo de las revisiones incluidas (p. ej., AMSTAR-2, ROBIS), y de la certeza de la evidencia (p. ej., GRADE).
¿Cómo hacer una revisión paraguas?
A continuación, un esquema operativo (paso a paso) alineado con recomendaciones metodológicas actuales:
1. Formular la pregunta de investigación y registrar del protocolo
Definir un objetivo claro y justificable (por qué una umbrella review es necesaria y qué aporta respecto a RS/MA existentes). Estructurar la pregunta con marcos adecuados, según el tipo de evidencia:
PICO(S) (efectividad clínica)
CoCoPop (prevalencia/etiología)
PEO (cualitativa o exposiciones)
Registrar el protocolo a priori (p. ej., PROSPERO u OSF) mejora transparencia y reduce duplicidades.
2. Definir criterios de inclusión y exclusión
Incluir exclusivamente síntesis de evidencia (RS con o sin MA). Excluir, salvo justificación explícita: estudios primarios, revisiones narrativas, guías, informes técnicos no sistemáticos.
3. Diseñar y ejecutar una búsqueda sistemática reproducible
La búsqueda debe ser exhaustiva, reproducible. Bases habituales: MEDLINE/PubMed, Cochrane Database of Systematic Reviews, Embase, Epistemonikos, Scopus y registros como PROSPERO. Es recomendable emplear filtros metodológicos validados para RS/MA cuando proceda.
4. Selección de estudios y extracción de datos
Este proceso debe ser realizado de forma independiente por al menos dos revisores para minimizar sesgos. La selección consiste en el cribado de títulos y resúmenes, seguido de la evaluación de textos completos frente a los criterios de elegibilidad. Para la extracción se utiliza un formulario estandarizado para recopilar características básicas (autores, año), objetivos, intervenciones, resultados cuantitativos, métodos de síntesis y evaluaciones de calidad de las RS incluidas.
5. Evaluar la calidad metodológica / riesgo de sesgo de las revisiones incluidas
Herramientas frecuentes:
AMSTAR-2 (calidad metodológica general)
ROBIS (riesgo de sesgo de la revisión sistemática)
Otras herramientas equivalentes, si están justificadas por el tipo de revisión.
6. Gestionar el solapamiento de estudios primarios (Overlap)
Un reto único de las umbrella reviews es que diferentes RS pueden incluir los mismos estudios primarios, lo que puede inflar artificialmente los resultados si se combinan cuantitativamente.
Construir una matriz de evidencia: Se recomienda crear una tabla que cruce las RS con los estudios primarios únicos.
Cuantificar el solapamiento con el cálculo del ACC: El uso del índice del Área Cubierta Corregida (CCA) permite cuantificar el solapamiento (leve <5%, moderado 6-10%, alto 11-15%, y muy alto >15%).
Considerar herramientas de apoyo como el software GROOVE para una representación gráfica del solapamiento.
7. Síntesis y análisis de los datos
Existen dos enfoques principales para presentar los hallazgos:
Síntesis narrativa: útil para mapear el campo, identificar patrones y discrepancias, sin recalcular efectos.
Reanálisis (Repeated Analysis): cuando es apropiado, reanalizar estimaciones (con cautela, especialmente por solapamiento y heterogeneidad), usando software como RevMan/Stata o paquetes de R (p. ej., metaumbrella).
8. Evaluación de la certeza de la evidencia
Aplicar GRADE (u otro sistema equivalente justificado) para clasificar la certeza final (alta, moderada, baja, muy baja) según riesgo de sesgo, inconsistencia, imprecisión, etc.
9. Reporte de los resultados transparente
Para overviews de revisiones, la guía PRIOR es una referencia útil para asegurar informe completo, reproducible y trazable. Esta lista de verificación de 27 ítems cubre todos los aspectos del ciclo de vida de la revisión, desde el título hasta la declaración de conflictos de interés, asegurando la transparencia y reproducibilidad de la síntesis.
Principales aportaciones del artículo de Liu et al. (2025)
Delimita con claridad las diferencias entre revisiones sistemáticas/metaanálisis, overviews y umbrella reviews, incluyendo su lugar en la jerarquía de la evidencia.
Propone un flujo metodológico estructurado: definición del tema y criterios, registro del protocolo, búsqueda y cribado, extracción, evaluación de calidad (p. ej., AMSTAR-2), valoración de certeza (p. ej., GRADE) y análisis.
Incorpora aspectos técnicos críticos para este tipo de síntesis, como el solapamiento de estudios primarios entre revisiones y la heterogeneidad, con recomendaciones prácticas para abordarlos y reportarlos.
¿Quieres evaluar tus conocimientos de las revisiones paraguas?
BIBLIOGRAFÍA
Liu C, Zhou D, Xu W, Pan H, Wang X, Peng J, Ji X, Huang J, Zhu Z. Umbrella Reviews: Concepts, Methodological Frameworks, and Step-by-Step Implementation. J Evid Based Med. 2025 Dec;18(4):e70092. doi: 10.1111/jebm.70092.
Durante años, Rayyan ha sido especialmente sólido en el cribado por título/resumen, pero muchos equipos (y, en particular, quienes coordinamos revisiones con volúmenes altos) nos encontrábamos con dificultades claras cuando el proyecto avanzaba hacia el texto completo y la gestión documental.
Las limitaciones de Rayyan
Históricamente, Rayyan se diseñó como herramienta de cribado y, aunque ha ido incorporando módulos posteriores, en la práctica cotidiana se repetían algunos problemas:
Gestión manual de textos completos (PDF): Los PDFs debían recuperarse fuera de Rayyan. Después, había que subirlos y adjuntarlos manualmente a cada registro, uno a uno.
Integración imperfecta del flujo de trabajo: Rayyan resultaba muy eficiente en el primer cribado, pero el proceso tendía a volverse más “pesado” en fases posteriores. Era frecuente recurrir a soluciones externas (carpetas compartidas, gestores bibliográficos paralelos, etc.) para poder trabajar con muchos PDFs de forma operativa.
La novedad: “Mi Biblioteca” (My Library)
Rayyan ha introducido Mi Biblioteca como un espacio estable, reutilizable y conectado a las revisiones, diseñado para centralizar archivos y reducir trabajo manual, especialmente en el cribado a texto completo.
En términos prácticos, “Mi Biblioteca” funciona como una biblioteca personal en la nube dentro de Rayyan, desde la que puedes organizar, conservar y reutilizar materiales (referencias, PDFs y otros archivos) en distintos proyectos.
Beneficios de «My Library»
1) Centralización y orden (por fin, “un sitio” para todo)
Permite almacenar una colección propia de investigación, con referencias y textos completos.
Puedes crear carpetas y estructurar el contenido por proyectos, temas o etapas.
Facilita la gestión de colecciones grandes con una lógica de “repositorio” (custodia y reutilización, no solo importación puntual).
2) Reutilización real entre proyectos
Una idea clave es evitar el “déjà vu” de reimportar lo mismo en cada revisión: “Mi Biblioteca” está pensada para que tu colección de referencias/archivos sea persistente y puedas usar los mismos ítems en revisiones diferentes cuando lo necesites.
3) El gran cuello de botella: texto completo (PDF) y su enlace al registro
Aquí está el salto más práctico: durante la fase de cribado a texto completo, puedes localizar PDF ya almacenados en Mi Biblioteca y vincularlos a los registros del proyecto, reduciendo el trabajo de “subir y adjuntar” uno por uno desde cero en cada revisión.
4) Recuperación y “copia de trabajo”
Todo lo que subes queda disponible para su reutilización y descarga, lo que aporta una capa útil de respaldo operativo (especialmente cuando el equipo trabaja con múltiples revisiones o rotación de participantes).
Implicaciones para bibliotecas hospitalarias y equipos de revisión
Reducir trabajo manual repetitivo.
Mejorar la trazabilidad (dónde está cada PDF, cuándo se incorporó, a qué proyecto se vinculó).
Disminuir dependencias de circuitos paralelos (carpetas compartidas + “doble” gestión fuera de la plataforma).
Cautelas (importantes)
No es un sistema de obtención de texto completo: “Mi Biblioteca” no sustituye el acceso: sigue siendo imprescindible disponer de los PDFs por vías legítimas (suscripción institucional, OA, solicitud a autores, etc.).
Qué puedes hacer con cuenta gratuita:
Subir y organizar PDFs y archivos de referencias en Mi Biblioteca, sin límite de espacio tan solo que cada PDF no exceda 100MB, y no subir más de 10 a la vez.
Reutilizar esas referencias en distintas revisiones.
Buscar PDFs en Mi Biblioteca durante el cribado a texto completo y emparejarlos manualmente con las referencias.
Qué queda restringido a planes de pago: El PDF Auto Matching (la asignación automática de PDFs a las referencias) es una funcionalidad solo de pago.
En resumen …
“Mi Biblioteca” supone una notable mejora, ya que actúa en el eslabón más frágil del flujo de trabajo en Rayyan: la gestión del texto completo y su acoplamiento al cribado. Para quienes trabajamos apoyando revisiones sistemáticas desde bibliotecas hospitalarias, este cambio puede traducirse en menos trabajo manual, más orden y más eficiencia en proyectos de alto volumen.
Hasta ahora, diseñar una estrategia de búsqueda sólida, localizar estudios relevantes y manejar cientos de referencias era un trabajo artesanal, intensivo en tiempo y dependiente por completo de la experiencia humana. Sin embargo, la integración de modelos de lenguaje generativo en los procesos de revisión sistemática está modificando de manera sustancial la fase de búsqueda y recuperación de información.
La clave está en entender qué puede hacer cada uno y cómo combinar sus fortalezas para obtener búsquedas más robustas, eficientes y reproducibles en un contexto donde la calidad de la evidencia importa más que nunca.
Tareas en las que puede intervenir la IA
La aportación de la IA no reside únicamente en la aceleración de tareas, sino en la capacidad de ampliar, diversificar y estructurar el acceso a la literatura científica, amplificando los procedimientos manuales.
Generación rápida y exhaustiva de términos de búsqueda. Los modelos de IA generativa son capaces de recopilar términos de miles de textos y, a partir de ahí, sugieren sinónimos, acrónimos y variantes de un mismo concepto. En otras palabras, ayudan a descubrir términos relevantes que, de otro modo, podrían pasarse por alto. Esta capacidad resulta especialmente útil en áreas emergentes o interdisciplinarias, donde la terminología aún no está normalizada y la literatura se dispersa en múltiples dominios temáticos.
Aumento de la sensibilidad/exhaustividad (recall) de la búsqueda. Estas herramientas son capaces de producir una primera estrategia de búsqueda con elevada sensibilidad, es decir, muy amplia, recuperando muchísimos resultados. Es verdad que luego hay que limpiarlos y depurarlos, pero esa “primera cosecha” sirve como una base sólida sobre la que seguir afinando la estrategia, añadir filtros y ajustar los términos. En este sentido, la IA funciona como un acelerador: te ayuda a arrancar rápido con un punto de partida fuerte, aunque siempre hace falta la mirada experta del bibliotecario para asegurar que todo tenga sentido y calidad.
Generación de búsquedas booleanas para distintas bases de datos/plataformas. Uno de los avances más visibles es la capacidad de la IA para traducir una estrategia conceptual en consultas operativas adaptadas a la sintaxis de cada proveedor: Ovid MEDLINE, Embase.com, Scopus, Web of Science, CINAHL (EBSCO, Ovid, …), PsycINFO (Proquest, EBSCO, …), entre otros. Esto incluye la aplicación correcta de campos de búsqueda, operadores de proximidad, truncamientos, tesauros controlados y peculiaridades funcionales de cada motor. Esta precisión reduce errores, evita pérdidas de sensibilidad y mejora la reproducibilidad del proceso.
Ventajas/Oportunidades del uso de la IA
Fase de búsqueda inicial más exhaustiva: La IA puede generar en pocos segundos un abanico enorme de términos, sinónimos y palabras clave relacionadas con un tema. Esto resulta especialmente útil cuando nos enfrentamos a un campo nuevo o del que sabemos poco: la herramienta propone conceptos que quizá no habríamos considerado y evita que la estrategia de búsqueda se quede corta.
Más referencias desde el principio: Las herramientas de IA suelen recuperar mucho más. Su forma de interpretar las palabras clave es más amplia que la nuestra, lo que se traduce en un volumen mayor de resultados. Luego tocará depurarlos, sí, pero arrancar con una red más grande ayuda a no dejar estudios relevantes fuera.
Menos tiempo perdido al adaptar estrategias entre bases de datos: Pasar una estrategia de búsqueda de MEDLINE (PubMed u OVID) a Embase.com, Scopus o WoS es un trabajo pesado, repetitivo y lleno de pequeños detalles que es fácil olvidar. La IA puede hacerlo automáticamente, respetando sintaxis, operadores booleanos y campos correctos en cada plataforma. En la práctica, esto supone menos errores y muchas horas ahorradas.
Orden y lógica en los términos: Además de reunir términos útiles, la IA es capaz de agruparlos por categorías o temas. No solo te dice qué palabras usar, sino que te ayuda a entender cómo se relacionan entre sí, lo que facilita estructurar la búsqueda con sentido.
Inconvenientes y retos del uso de IA en las revisiones sistemáticas
Mucho volumen, poca precisión: Que la IA recupere cientos o miles de referencias puede parecer una ventaja, pero tiene trampa: no distingue bien lo relevante de lo accesorio. Esto obliga a dedicar tiempo extra a revisar y descartar estudios que no encajan con la pregunta de investigación. En cambio, una estrategia elaborada por un bibliotecario suele ser más ajustada desde el principio, porque está pensada para responder a criterios concretos y no para abarcar “todo lo que pueda sonar parecido”.
La experiencia humana sigue siendo irremplazable: La IA propone muchos términos, sí, pero no sabe cuándo un matiz importa. Afinar la estrategia de búsqueda, elegir el descriptor correcto o decidir si un término aporta ruido o información útil sigue siendo territorio humano. Las listas generadas por la IA necesitan ser revisadas, depuradas y enriquecidas por alguien que entienda el contexto, las particularidades del tema y las implicaciones metodológicas.
Limitaciones de acceso a bases de datos suscritas: Hoy por hoy, la mayoría de modelos de IA no pueden entrar en bases de datos científicas de pago. Esto significa que no pueden comprobar en tiempo real qué términos están indexados, qué descriptores existen o cómo se estructura un determinado tesauro especializado.
No puede moverse por tesauros especializados: Al no tener acceso a bases como EMBASE, CINAHL o PsycINFO, la IA no es capaz de navegar por sus tesauros y proponer descriptores correctos. Este es un punto crítico porque las estrategias de búsqueda más sólidas combinan términos libres con términos controlados, y esa fineza todavía no está al alcance de las herramientas generativas.
No descarga ni extrae referencias: Otra limitación importante es que la IA no puede descargar los resultados de la búsqueda ni gestionarlos en un gestor bibliográfico. Sigue siendo necesario pasar por las plataformas originales para obtener los registros y preparar la deduplicación o el cribado.
Siempre necesita supervisión: El uso de IA no elimina la figura del bibliotecario experto ni del equipo de revisión. Más bien cambia su papel: deja de ser quien hace cada paso manualmente para convertirse en quien valida, corrige y toma decisiones informadas. Sin esa supervisión, la IA puede generar estrategias amplias, pero no necesariamente adecuadas.
Un modelo sinérgico: IA + bibliotecario
El futuro inmediato no pasa por elegir entre inteligencia artificial o bibliotecario especializado, sino por combinarlos teniendo en cuenta las fortalezas y limitaciones de cada uno de ellos. Cada uno aporta algo diferente y, cuando trabajan juntos, el proceso de búsqueda y revisión gana en velocidad, alcance y rigor.
¿Cuál sería el rol de la IA? La IA es especialmente útil en las primeras fases del trabajo. Su fortaleza está en generar cantidad: propone términos, sugiere combinaciones, construye borradores de estrategias de búsqueda y automatiza tareas tediosas como adaptar consultas entre plataformas o expandir sinónimos. Es rápida y eficiente para mover grandes volúmenes de información.
¿Qué aporta el bibliotecario? El bibliotecario, por su parte, aporta calidad. No solo afina la terminología y valida los conceptos relevantes, sino que es quien domina el uso de tesauros, entiende la lógica de indexación de cada base de datos y detecta inconsistencias que la IA no ve. Además, garantiza el rigor metodológico: sabe cuándo un término es demasiado amplio, cuándo un operador puede distorsionar la pregunta de investigación y cómo documentar correctamente una estrategia reproducible.
La IA debe usarse como compañera de los humanos, no como sustituta.
Tú eres, en última instancia, responsable de su síntesis de la evidencia, incluida la decisión de usar IA y de garantizar la adhesión a las normas legales y éticas.
Usa la IA siempre que no comprometas el rigor metodológico ni la integridad de la síntesis.
Debes de informar de forma completa y trasparente del uso de cualquier IA que emita o sugiera juicios.
La inteligencia artificial (IA) puede acelerar y reforzar fases concretas de una revisión sistemática (RS), pero no sustituye el juicio metodológico ni la verificación humana. Esta guía resume cuándo y cómo usarla con seguridad, qué supervisión aplicar y cómo documentar su empleo en protocolos y manuscritos. Esta es una guía práctica y aplicada para equipos de revisión sistemática que desean comenzar a incorporar herramientas de inteligencia artificial (IA) de forma responsable, alineada con la declaración conjunta Cochrane–Campbell–JBI–CEE y las recomendaciones RAISE.
1) Antes de usar IA: 4 decisiones clave
Evalúa la necesidad real. Si la IA no mejora eficiencia o calidad (p. ej., por bajo volumen o buen rendimiento del equipo), no la uses.
Analiza el contexto. Urgencia, alcance, recursos, tipo de datos (cuantitativos/cualitativos) e impacto esperado condicionan la elección de herramientas.
Selecciona con criterio. Prioriza herramientas con validación pública y documentación completa; comprueba si han sido entrenadas en dominios afines a tu tema.
Consulta a metodólogos y expertos si es posible.
2) ¿Dónde aporta valor la IA? (y qué control aplicar)
3) Buenas prácticas de reporte
Incluye de forma transparente: herramienta y versión; objetivo de uso (cribado, extracción, redacción…); justificación metodológica (validación/ utilidades); verificación aplicada; limitaciones y posibles sesgos; conflictos de interés; y dónde están código, prompts o I/O (si aplica).
Consejo: Incluye esta información en el apartado Métodos y/o en Material suplementario.
Plantilla genérica de informes que podría usarse adatánda para informar del uso de la IA en RS
We will use [AI system/tool/approach name, version, date] developed by [organization/developer] for [specific purpose(s)] in [the evidence synthesis process]. The [AI system/tool/approach] will [state it will be used according to the user guide, and include reference, and/or briefly describe any customization, training, or parameters to be applied]. Outputs from the [AI system/tool/approach] are justified for use in our synthesis because [describe how you have determined it is methodologically sound and will not undermine the trustworthiness or reliability of the synthesis or its conclusions and how it has been validated or calibrated to ensure that it is appropriate for use in the context of the specific evidence synthesis, if not covered in the user guide, evaluations or elsewhere]. Limitations [of the AI system/ tool/approach] include [describe known limitations, potential biases, and ethical concerns]/[are included as a supplementary material]. [If applicable] A detailed description of the methodology, including parameters and validation procedures, is available in [supplementary materials].
4) Cómo informar el uso de IA en protocolo y manuscrito
5. Formación del equipo
Competencias mínimas recomendadas
Saber interpretar evaluaciones de herramientas de IA
Comprender sesgos algorítmicos (e.g., sesgo de idioma, acceso abierto)
Saber aplicar criterios éticos y legales (protección de datos, plagio)
Capacidad de diseñar prompts precisos y reproducibles si se usan LLMs
La IA optimiza tareas repetitivas y ayuda a estructurar información, pero su fiabilidad depende de una elección informada, pilotaje previo, verificación sistemática y transparencia en el reporte. Si no mejora la eficiencia o la calidad de la RS, no la utilices.
Bibliografía
Flemyng, E., Noel-Storr, A., Macura, B., Gartlehner, G., Thomas, J., Meerpohl, J. J., Jordan, Z., Minx, J., Eisele-Metzger, A., Hamel, C., Jemioło, P., Porritt, K., & Grainger, M. (2025). Position statement on artificial intelligence (AI) use in evidence synthesis across Cochrane, the Campbell Collaboration, JBI and the Collaboration for Environmental Evidence 2025. Environmental Evidence, 14(1), 20, s13750-025-00374–00375. https://doi.org/10.1186/s13750-025-00374-5
Thomas, J., Flemyng, E., Noel-Storr, A., Moy, W., Marshall, I. J., Hajji, R., Jordan, Z., Aromataris, E., Mheissen, S., Clark, A. J., Jemioło, P., Saran, A., Haddaway, N., Kusa, W., Chi, Y., Fletcher, I., Minx, J., McFarlane, E., Kapp, C., … Gartlehner, G. (2025). Responsible AI in Evidence Synthesis (RAISE) 1: Recommendations for practice. https://osf.io/fwaud
A comienzos del siglo XX, Berlín contuvo el aliento ante un caballo. Lo llamaban Hans y, frente a una pizarra de números, hacía sonar el casco como si cada golpe arrancara una cifra del aire. La multitud juraba ver inteligencia en su mirada; su entrenador, Wilhelm von Osten, lo presentaba sin cobrar entrada, como quien ofrece un pequeño milagro.
“Hans el Listo” en acción, golpeando con su casco. Disponible en: Samhita L, Gross HJ. The «Clever Hans Phenomenon» revisited. Commun Integr Biol. 2013 Nov 1;6(6):e27122. doi: 10.4161/cib.27122.
El asombro fue tan grande que, entre 1904 y 1907, se organizó una investigación oficial. Primero, la llamada Comisión Hans descartó engaños burdos: no había hilos, ni claves pactadas, ni trucos circenses. Después, el psicólogo Oskar Pfungst diseñó experimentos controlados: cambió al interrogador, ocultó las expresiones faciales, varió la posición del público e incluso impidió el contacto visual. Cuando quien preguntaba no conocía la respuesta, o cuando Hans no podía “leer” a las personas, el caballo fallaba.
Pero el prodigio tenía costuras humanas: Hans no resolvía aritmética, leía cuerpos; detectaba señales mínimas —una ceja, un leve enderezarse el cuerpo, la respiración que se cambia justo en el número esperado— y detenía su casco en el punto exacto de la expectativa ajena. Así nació el término que aún usamos en ciencia: el “efecto Clever Hans”.
Esta historia es un espejo útil para la inteligencia artificial moderna. Los modelos –de GPT-4 no “descifran” el mundo: ajustan sus salidas a los patrones y pistas presentes en los datos, en las instrucciones y en el contexto que les damos. Igual que Hans, responden con asombrosa verosimilitud cuando las señales son ricas y la guía es nítida; y, también como Hans, fallan cuando retiramos esas pistas o las contaminamos. La enseñanza no es que el caballo fuera un fraude, sino que nuestra mirada lo era sin querer: fuimos nosotros quienes, con gestos invisibles, le dictamos la respuesta.
La inteligencia que creíamos observar estaba en la coreografía invisible de quienes hacían la pregunta. Hoy, cuando diseñamos, probamos o usamos sistemas de IA, necesitamos protocolos tan estrictos como los de Pfungst: preguntas ciegas, controles que eviten pistas espurias, validaciones con datos no vistos y entornos donde la respuesta correcta no pueda “adivinarse” por atajos. Porque la frontera entre comprender y simplemente complacer nuestras expectativas puede ser tan fina como el temblor de un músculo.
BIBLIOGRAFÍA
Samhita L, Gross HJ. The «Clever Hans Phenomenon» revisited. Commun Integr Biol. 2013 Nov 1;6(6):e27122. doi: 10.4161/cib.27122.
Khraisha Q, Put S, Kappenberg J, Warraitch A, Hadfield K. Can large language models replace humans in systematic reviews? Evaluating GPT-4’s efficacy in screening and extracting data from peer-reviewed and grey literature in multiple languages. Res Synth Methods. 2024 Jul;15(4):616-626. doi: 10.1002/jrsm.1715.
Pfungst O. Clever Hans (The Horse of Mr. von Osten): A contribution to experimental animal and human psychology. New York: Henry Holt; 1911. Project Gutenberg (eBook n.º 33936). Disponible en: https://www.gutenberg.org/ebooks/33936?
Aunque la IA tiene el potencial de transformar los procesos y hacer la síntesis más oportuna, asequible y sostenible, la tecnología es potencialmente disruptiva y conlleva riesgos como la opacidad, el sesgo algorítmico y la creación de contenido fabricado (alucinaciones).
Recientemente se ha desarrollado la guía RISE (Responsible use of AI in evidence SynthEsis) para abordar la necesidad de un consenso sobre qué constituye el uso responsable de los LLMs. Cochrane y JBI han adoptado una posición conjunta y oficial respecto al uso de la Inteligencia Artificial (IA) en la síntesis de evidencia, la cual está formalmente alineada con las recomendaciones RAISE (Responsible use of AI in evidence SynthEsis). Esta postura se estableció en colaboración con la Campbell Collaboration y la Collaboration for Environmental Evidence (CEE), formando un Grupo Conjunto de Métodos de IA (1).
¿Qué son los principios RAISE?
RISE establece un marco de trabajo para garantizar el uso responsable de la inteligencia artificial (IA) y la automatización a lo largo de todo el ecosistema de la síntesis de evidencia. Tiene como objetivo Salvaguardar los principios esenciales de la integridad de la investigación frente a la integración creciente de la IA (2).
Inteligencia artificial dentro del marco RISE
Los autores podrán integrar la inteligencia artificial en sus procesos de síntesis de evidencia y preparación de manuscritos, siempre que se garantice que su uso no comprometerá el rigor metodológico ni la integridad de la evidencia sintetizada. Su implementación debe estar debidamente justificada y sustentada por la solidez metodológica de las herramientas empleadas.
Cómo se implementan las recomendaciones RISE
RISE establece tres categorías principales de recomendaciones para los autores de síntesis de evidencia:
Pilar 1. Responsabilidad última: la firma es tuya.
El autor es el responsable final del contenido, los métodos y los hallazgos de su síntesis, incluyendo la decisión de usar la IA, cómo se emplea y el impacto que tiene en el resultado. El equipo autor responde del contenido, métodos y hallazgos, incluida ladecisión de usar IA, cómo se usa y su impacto. Antes de adoptar herramientas, sé crítico: ¿hacen lo que prometen?, ¿con qué limitaciones?, ¿encajan con tu pregunta y contexto? Justifica el uso: demuestra solidez metodológica y que no compromete la confianza en resultados y conclusiones.
Declara la IA cuando hace o sugiere juicios (elegibilidad, riesgo de sesgo, extracción, síntesis, GRADE, resúmenes). No suele ser necesario declarar correcciones menores de ortografía/gramática, salvo que la revista lo exija.
Incluye siempre:
Nombre(s) del/de los sistema(s) o herramienta(s) de IA, versión(es) y fecha(s) de uso.
Para qué la usaste y en qué fases; guía y cómo se aplicó (incluidas modificaciones).
Justificación y evidenciade desempeño/limitaciones; cómo validaste/pilotaste su uso.
Disponibilidad (si es viable): prompts, salidas, datasets, código; y pasos de verificación.
Intereses (financieros/no financieros) respecto a la herramienta y su financiación.
Limitaciones y sesgos detectados y su posible impacto. Alinea con PRISMA/ROSES y colócalo donde pida la revista (Métodos, Agradecimientos o sección específica).
PILAR 3. Consideraciones éticas y legales.
Cuida plagio, autoría, derechos y licencias, confidencialidad y protección de datos. Si tratas datos sensibles, extrema las garantías.
Plantilla para declarar el uso de IA (copiar/pegar)
Aquí te dejo un ejemplo de modelo de plantilla que puedes utilizar en tu próxima revisión:
Uso de IA y automatización: Durante esta revisión utilizamos [Nombre-herramienta, versión] (acceso el [fecha]) para [fases: búsqueda/cribado/extracción/síntesis/resumen]. Aplicamos [parámetros/modificaciones] y validamos su desempeño mediante [piloto, muestreo, doble ciego, comparación con estándar]. Conservamos prompts, salidas y registros en [repositorio/suplemento]. El equipo no declara [intereses/relaciones] con el proveedor. Limitaciones observadas: [listar]; impacto potencial: [describir]. La decisión final sobre elegibilidad, extracción y conclusiones fue humana.
Tabla traducida al español de RAISE (versión 2.1 en desarrollo a partir del 22 de septiembre de 2025)
Categoría RISE
Más orientación
Mantener la responsabilidad última de la síntesis de evidencia
– El autor es responsable del contenido, los métodos y los hallazgos de su síntesis de evidencia, incluida la decisión de usar IA, cómo se usa y su impacto en la síntesis. – Al considerar el uso de un sistema o herramienta de IA, sea crítico con sus evaluaciones para comprender si hace lo que declara con un nivel adecuado, así como sus limitaciones y si puede aplicarse al contexto de la síntesis específica. – El uso de la IA debe estar justificado y debe demostrarse que las herramientas son metodológicamente sólidas, que no socavan la confiabilidad o fiabilidad de la síntesis ni de sus conclusiones y que es apropiado usar un sistema o herramienta de IA específica en el contexto de la síntesis concreta.
Informar de manera transparente el uso de IA en el manuscrito de la síntesis de evidencia
– Los autores pueden utilizar IA dentro de sus síntesis y para preparar su manuscrito. – Los autores deben declarar cuándo han utilizado IA si esta realiza o sugiere juicios, por ejemplo en relación con la elegibilidad de un estudio, valoraciones (incluida la evaluación del riesgo de sesgo), extracción de datos bibliográficos, numéricos o cualitativos de un estudio o de sus resultados, síntesis de datos de dos o más estudios, valoración de la certeza de la evidencia (incluidos los dominios de GRADE o las calificaciones globales de certeza para un desenlace o hallazgo), redacción de texto que resume la solidez global de la evidencia, las implicaciones para la toma de decisiones o la investigación, o resúmenes en lenguaje sencillo. En general, no es necesario consignar la IA utilizada únicamente para mejorar ortografía, gramática o la estructura del manuscrito, pero recomendamos comprobar la política específica de la revista para asegurar el cumplimiento. – Cumplir con los estándares de notificación establecidos por cada revista, como PRISMA o ROSES. PRISMA, por ejemplo, incluye ítems sobre la notificación de herramientas de automatización usadas en diferentes etapas del proceso de síntesis. Esto debe informarse en la sección especificada por cada revista, como Agradecimientos, Métodos o una sección específica para la divulgación del uso de IA. Si los detalles son extensos o la IA se usa en múltiples etapas, considere materiales suplementarios o una presentación tabular (o ambos). En general, los autores deben informar de lo siguiente: a) Nombre(s) del/de los sistema(s), herramienta(s) o plataforma(s) de IA, versión(es) y fecha(s) de uso. b) El propósito del uso de IA y qué partes del proceso de síntesis de evidencia se vieron afectadas. Citar o referenciar la guía de uso o describir cómo se empleó la IA, incluidas las modificaciones aplicadas. c) La justificación para usar IA, incluida la evidencia de que el sistema o herramienta de IA es metodológicamente sólida y no socavará la confianza o la fiabilidad de la síntesis o de sus conclusiones (p. ej., citando o referenciando evaluaciones de desempeño que detallen el impacto de errores, limitaciones y generalización), y cómo se ha validado (y pilotado, si procede) para asegurar que es apropiada en el contexto de la síntesis específica. Siempre que sea posible y práctico, poner a disposición pública y gratuita las entradas (p. ej., desarrollo de prompts), salidas, conjuntos de datos y código (por ejemplo, en repositorios o como materiales suplementarios) y describir los pasos seguidos para verificar las salidas generadas por IA. d) Cualesquiera intereses financieros y no financieros de los autores de la síntesis respecto del sistema o herramienta de IA, junto con las fuentes de financiación del propio sistema o herramienta de IA. e) Cualesquiera limitaciones del uso de IA en los procesos de la revisión, incluidos sesgos potenciales. Comentar el impacto potencial de cada limitación.
Garantizar el cumplimiento de estándares éticos, legales y normativos al usar IA
Asegúrese de cumplir los estándares éticos, legales y normativos al aplicar IA en su síntesis. Por ejemplo, tenga en cuenta cuestiones relacionadas con plagio, procedencia, derechos de autor, propiedad intelectual, jurisdicción y licencias; y con la confidencialidad, el cumplimiento normativo y las responsabilidades de privacidad, incluidas las leyes de protección de datos.
Conclusión
RAISE no frena la innovación: la encauza. La guía RISE establece un hito esencial en la evolución de la síntesis de evidencia científica. Al definir principios claros para el empleo responsable de la inteligencia artificial, RISE no pretende restringir la innovación, sino orientarla para preservar y robustecer los valores intrínsecos de la investigación rigurosa.
El futuro de la síntesis de evidencia será, ineludiblemente, más automatizado. No obstante, con RISE como pauta, será también más responsable, transparente y fiable. Los investigadores que adopten estos principios no solo utilizarán herramientas poderosas de forma ética, sino que contribuirán a edificar un ecosistema de investigación más sólido y digno de confianza para las generaciones futuras.
Bibliografía
Flemyng E., Noel-Storr A., Macura B., Gartlehner G., Thomas J., Meerpohl JJ., et al. Position statement on artificial intelligence (AI) use in evidence synthesis across Cochrane, the Campbell Collaboration, JBI and the Collaboration for Environmental Evidence 2025. Environ Evid. 2025;14(1):20, s13750-025-00374-5, doi: 10.1186/s13750-025-00374-5.
Thomas J, Flemyng E, Noel-Storr A, Moy W, Marshall IJ, Hajji R, et al. Responsible use of AI in evidence SynthEsis (RAISE) 1: recommendations for practice. In: Open Science Framework, Washington DC: Center for Open Science. https ://doi.org/10.17605/OSF.IO/FWAUD. https://osf.io/.
La inteligencia artificial (IA)—y, en particular, los modelos de lenguaje (LLMs)—ya están ayudando a hacer revisiones sistemáticas (RS) más rápidas y manejables, pero aún no pueden reemplazar el juicio experto ni los métodos sistemáticos consolidados. A continuación resumo qué funciona, qué no, y cómo implantarlo con garantías.
Qué dice la evidencia más reciente sobre LLMs
Una revisión de alcance (n=196 informes; 37 centrados en LLMs) encontró que los LLMs ya se usan en 10 de 13 pasos de la RS (sobre todo búsqueda, selección y extracción). GPT fue el LLM más común. La mitad de los estudios calificó su uso como prometedor, un cuarto neutral y un quinto no prometedor. La búsqueda fue, con diferencia, el paso más cuestionado; en RoB la concordancia con humanos fue solo ligera a aceptable (Lieberum JL, et al. 2024).
¿Dónde aporta más (hoy) la IA?
La IA acelera y prioriza (especialmente en el cribado), pero no sustituye la búsqueda sensible, la evaluación del sesgo ni el juicio experto.
1) Cribado (títulos/resúmenes y, con matices, texto completo)
Aprendizaje activo para priorizar lo relevante primero: Ayudar al revisor humano a reordenar los artículos para presentar primero los más relevantes (aprendizaje activo). ASReview y SWIFT ActiveScreener alcanzaron recall altos en títulos/resúmenes (96,48% y 97,89%, respectivamente) y redujeron el number needed to read (NNR). En texto completo, Covidence y SWIFT obtuvieron recall100% con precisión cercana al 50%, útil para priorizar sin suprimir la revisión humana.
Su uso en la primera fase del cribado frente al título/Abstract es prometedor pudiendo reducir la carga de trabajo significativamente, especialmente para el segundo revisor.
Su uso en la fase de escreening frente al texto completo es limitado y todos los artículos deben cribarse para garantizar que no se pierda nada, a pesar de la precisión de la IA
La implicación general es que la IA en esta fase debe verse como una herramienta complementaria y de apoyo, y no como un sustituto completo del juicio y la experiencia humana
2) Extracción de datos (modo asistido)
LLMs y asistentes tipo ChatGPT/Elicit/SciSpace pueden pre-rellenar tablas (autor, año, muestra, intervención…), pero la concordancia varía del 0% al 100% según el campo, y entre herramientas la fiabilidad puede ser baja-moderada; exige verificación por dos extractores humanos.
La extracción de datos es una de las fases del proceso de RS más frecuentemente abordadas por estudios sobre LLMs (Modelos de Lenguaje Grande). La IA puede identificar y extraer información clave, como el diseño del estudio, los resultados, o el tema principal de un artículo, lo que potencialmente minimiza el error humano y reduce el esfuerzo manual3. Dado que la extracción de datos, junto con el cribado, es una de las partes que más tiempo consume en una RS, la capacidad de herramientas como ChatGPT y CoPilot para acelerar esta fase es considerada un beneficio importante. Sin embargo, pesar de los resultados prometedores, la IA aún no está lista para reemplazar la extracción manual y presenta importantes fallas de fiabilidad.
3) Apoyo metodológico y redacción
Buen rendimiento para ideación de la pregunta, PICO, sinónimos y borradores de cadenas booleanas (que un especialista debe validar). En redacción, los LLMs ayudan a esqueletos de métodos/discusión y a preparar síntesis narrativas con control experto.
¿Dónde no conviene delegar (aún)?
A) Búsqueda bibliográfica “end-to-end”: rol de apoyo y supervisión humana
El debate en torno al uso de la Inteligencia Artificial (IA) en la fase de Búsqueda en las Revisiones Sistemáticas se centra en su prometedor potencial para agilizar tareas específicas, contrarrestado por una baja fiabilidad y sensibilidad al intentar reemplazar la metodología de búsqueda tradicional, lo que exige una constante supervisión humana.
Baja Sensibilidad (Recall). Los buscadores IA (p. ej., Consensus, Elicit, SciSpace) mostraron recall muy bajo frente a estrategias manuales multibase: mejor caso ~18% y, en varios escenarios, 0–5%, en parte por cubrir Semantic Scholar y no bases con licencia/tras muro de pago. No sustituyen a MEDLINE/Embase/Scopus/WoS.
Alucinaciones y falta de fiabilidad en las referencias.
Inconsistencia en la Generación de Queries. Incluso cuando se limitan a la tarea de generar queries booleanas para bases de datos (un rol de asistencia), los resultados son impredecibles. Los LLMs no pueden recomendarse para la creación de estrategias de búsqueda complejas.
La IA puede utilizarse para identificar términos clave para el desarrollo de la estrategia y para tareas generales de alcance.
Es crucial que un bibliotecario experto con conocimientos en metodología de revisión valide la estrategia generada por la IA y la edite manualmente, ya que las estrategias generadas por ChatBots podría comprometer los resultados. Se requieren habilidades de prompt engineering para optimizar el rendimiento de la IA en tareas de recuperación de información.
B) Riesgo de sesgo (RoB): esta etapa requiere juicio humano
El debate en torno al Rendimiento de las herramientas de Inteligencia Artificial (IA), como ChatGPT y RobotReviewer, en la etapa de Evaluación de Calidad o Riesgo de Sesgo (RoB) de las Revisiones Sistemáticas (RS), se centra en su pobre fiabilidad inter-evaluador (poor inter-rater reliability) y sus limitaciones metodológicas, lo que las hace actualmente inadecuadas para reemplazar la evaluación humana.
C) Extracción desde tablas/figuras complejas
Los LLMs fallan más cuando los datos están en tablas/figuras o mal estructurados; se necesita lectura experta y herramientas específicas de tablas.
Flujo recomendado: IA-asistida, humano en el bucle
Riesgos (y cómo mitigarlos)
Alucinaciones y referencias falsas → Verificar DOI/PMID y cotejar con texto original.
Reproducibilidad inestable (prompts/temperatura) → Guardar prompts, fijar parámetros, usar corpus cerrado (RAG) cuando sea posible.
Recuerda:
Bibliografía
Kowalczyk P. Can AI Review the Scientific Literaure? Nature. 2024;635:276-8, doi: 10.1038/d41586-024-03676-9.
Lieberum J-L., Töws M., Metzendorf M-I., Heilmeyer F., Siemens W., Haverkamp C., et al. Large language models for conducting systematic reviews: on the rise, but not yet ready for use – a scoping review. 2024, doi: 10.1101/2024.12.19.24319326.
Moens M., Nagels G., Wake N., Goudman L. Artificial intelligence as team member versus manual screening to conduct systematic reviews in medical sciences. iScience. 2025;28(10), doi: 10.1016/j.isci.2025.113559.
Schmidt L., Cree I., Campbell F., WCT EVI MAP group Digital Tools to Support the Systematic Review Process: An Introduction. Evaluation Clinical Practice. 2025;31(3):e70100, doi: 10.1111/jep.70100.
El resumen es, a menudo, la única parte de un artículo que muchos lectores llegan a consultar. Es la primera puerta de entrada para investigadores, clínicos, revisores y facilita la comprensión rápida de los objetivos, métodos y resultados principales de un estudio. Pero además cumple un papel esencial en la recuperación de información: en bases de datos y motores de búsqueda -especialmente si no disponen de tesauro- las búsquedas se realizan fundamentalmente en los campos de título y resumen, y no en el texto completo de los artículos. Esto significa que, si los conceptos clave del estudio no están descritos de forma clara y completa en el resumen, es probable que el artículo no sea recuperado en una búsqueda bibliográfica, aunque sea muy relevante para la pregunta de investigación.
La calidad del resumen no solo es importante para que los lectores comprendan el estudio, sino también para que el artículo sea recuperable y visible en las búsquedas bibliográficas.
En un contexto donde cada vez se publican más artículos, los resúmenes no solo son leídos por personas, sino también procesados por herramientas automáticas de cribado y algoritmos de inteligencia artificial que ayudan en la selección de estudios para revisiones sistemáticas.
Un artículo reciente publicado en el Journal of Clinical Epidemiology (Write Your Abstracts Carefully – The Impact of Abstract Reporting Quality on Findability by Semi-Automated Title-Abstract Screening Tools, Spiero et al., 2025) demuestra con claridad esta idea:
Resúmenes de mayor calidad (medidos con los criterios TRIPOD) son más fáciles de identificar como relevantes por herramientas de cribado semiautomatizado.
El uso de subapartados en resúmenes estructurados también aumenta la probabilidad de que los artículos sean detectados.
En cambio, aspectos como la longitud del resumen o la variación terminológica no influyen en la capacidad de las herramientas para identificar artículos relevantes.
¿Por qué es importante esto?
Porque si los resúmenes están mal redactados, los estudios relevantes pueden pasar desapercibidos, lo que introduce sesgo de selección en las revisiones sistemáticas, y debilita la calidad de la síntesis de la evidencia.
Implicaciones prácticas
Para los autores de los artículos:
Redactar resúmenes completos, claros y estructurados, siguiendo las guías de reporte, aumenta la visibilidad de sus estudios en revisiones sistemáticas.
Una mala calidad de resumen puede traducirse en menor probabilidad de ser incluido en síntesis de evidencia, incluso si el estudio es relevante.
Para los equipos de revisiones sistemáticas:
Deben ser conscientes de que los algoritmos de cribado dependen de la calidad del resumen: resúmenes pobres pueden ser omitidos por las herramientas.
Es recomendable mantener estrategias de búsqueda amplias y sensibles, y vigilar el posible sesgo por omisión de estudios relevantes con resúmenes deficientes.
Documentar esta limitación metodológica en los protocolos y discusiones de las revisiones.
Para los bibliotecarios:
Al apoyar en búsquedas y cribado, conviene alertar sobre el riesgo de sesgo asociado a resúmenes mal redactados.
Los bibliotecarios pueden desempeñar un papel formativo, promoviendo la adhesión a guías de reporte (CONSORT, STROBE, TRIPOD…) entre investigadores y clínicos.
En la práctica, esto refuerza el papel del bibliotecario como garante de la calidad metodológica y transparencia en la síntesis de la evidencia.
En definitiva, escribir un buen resumen no es solo un ejercicio de comunicación científica: es una garantía de visibilidad, accesibilidad y rigor científico.
Referencia
Spiero I, Leeuwenberg AM, Moons KGM, Hooft L, Damen JAA, Write Your Abstracts Carefully – The Impact of Abstract Reporting Quality on Findability by Semi-Automated Title-Abstract Screening Tools. J Clin Epidemiol. 2025, doi: https://doi.org/10.1016/j.jclinepi.2025.111987.
En la literatura científica se habla mucho de cómo implementar prácticas basadas en la evidencia, pero mucho menos de cómo desimplementar aquellas que han demostrado ser ineficaces o incluso dañinas.
Las prácticas de bajo valor se consideran una fuente de “desperdicio” en los sistemas sanitarios: en EE. UU., se calcula que la atención de bajo valor supone entre 75 y 100 mil millones de dólares al año. La desimplementación no es simplemente “dejar de hacer algo”, sino un proceso activo que requiere superar barreras culturales, organizativas y de expectativas de pacientes y profesionales. Al igual que la implementación de prácticas de alto valor, la desimplementación es lenta: el artículo muestra que pueden pasar de 4 a 16 años hasta lograr una reducción del 50 % en el uso de ciertas pruebas.
Un reciente artículo publicado en BMJ Quality & Safety (LeLaurin JH, et al., 2025) analiza precisamente este aspecto: el tiempo que tarda el sistema sanitario en dejar de utilizar cribados oncológicos de bajo valor, es decir, pruebas que no aportan beneficio real al paciente y que pueden generar costes innecesarios, ansiedad o complicaciones derivadas de procedimientos invasivos.
El artículo revisa el tiempo necesario para la desimplementación de prácticas de cribado oncológico de bajo valor en EE. UU. (clasificadas como Grade D por la USPSTF). Se estudian seis prácticas: cribado de cáncer cervical en <21 y >65 años, cribado de próstata en ≥70 años, y cribados de ovario, tiroides, testículo y páncreas en adultos asintomáticos.
Lo que muestra el estudio
En el caso del cribado de cáncer de cuello uterino:
en mujeres menores de 21 años, se tardaron solo 4 años en reducir su uso a la mitad.
en mayores de 65 años, la desimplementación llevó 16 años.
En el cribado de próstata en varones ≥70 años, más de una década después de publicarse las guías, aún no se ha alcanzado la reducción del 50 %.
Para otros cribados (ovario, tiroides, testículo, páncreas), la falta de datos fiables impide conocer el tiempo de desimplementación.
Barreras para la desimplementación
Deficiente diseminación de la evidencia: los hallazgos que muestran la ineficacia o los daños de ciertas prácticas no siempre llegan de manera efectiva a los profesionales.
Normas y hábitos arraigados: la inercia clínica y la práctica establecida dificultan abandonar procedimientos habituales.
Resistencia al cambio: tanto de profesionales como de pacientes, que pueden percibir la retirada de una práctica como pérdida de calidad en la atención.
Confusión y escepticismo: los cambios frecuentes en las guías clínicas generan dudas y desconfianza en la validez de las recomendaciones.
Expectativas de los pacientes: algunos esperan recibir pruebas o tratamientos de rutina, incluso cuando no son necesarios, lo que ejerce presión sobre los médicos para mantenerlos.
Necesidad de atención personalizada y decisión compartida: en algunos casos puede justificarse un uso selectivo de la práctica en pacientes concretos, lo que complica su retirada universal.
Consecuencias no deseadas de la desimplementación:
reducción de ingresos en el sistema sanitario,
utilización inapropiada de otras prácticas,
pérdida de confianza por parte de los pacientes.
Conclusiones
Retirar de forma sistemática el cribado oncológico de bajo valor podría aumentar la eficiencia de los sistemas de salud, mejorar los resultados en salud (menos efectos adversos y menos ansiedad en pacientes), reducir los costes de la atención sanitaria y aumentar la eficiencia de los sistemas de salud.
Si implementar lo nuevo ya es lento (de media 15 años para que una innovación llegue al 50 % de uso), abandonar lo que no funciona puede ser aún más difícil y desigual. De ahí la importancia de contar con estrategias activas de desimplementación, sistemas de monitorización sólidos y profesionales de la salud comprometidos con la mejora continua.
Bibliografía
LeLaurin JH, Pluta K, Norton WE, Salloum RG, Singh Ospina N. Time to de-implementation of low-value cancer screening practices: a narrative review. BMJ Qual Saf. 2025 Jul 18;34(8):547-555. doi: 10.1136/bmjqs-2025-018558.
Shrank WH, Rogstad TL, Parekh N. Waste in the US Health Care System: Estimated Costs and Potential for Savings. JAMA. 2019 Oct 15;322(15):1501-1509. doi: 10.1001/jama.2019.13978.
Khan S , Chambers D , Neta G . Revisiting time to translation: implementation of evidence-based practices (EBPs) in cancer control. Cancer Causes Control 2021;32:221–30. doi:10.1007/s10552-020-01376-z
La inteligencia artificial está irrumpiendo con fuerza en la síntesis de evidencia. Un estudio reciente de la Agencia Canadiense de Medicamentos (CDA-AMC) ofrece datos interesantes que conviene conocer (Featherstone R, Walter M, MacDougall D, Morenz E, Bailey S, Butcher R, et al. Artificial Intelligence Search Tools for Evidence Synthesis: Comparative Analysis and Implementation Recommendations. Cochrane Evidence Synthesis and Methods. 2025;3(5):e70045, doi: 10.1002/cesm.70045.).
Este artículo tuvo como objetivo evaluar el potencial de herramientas de búsqueda basadas en inteligencia artificial (Lens.org, SpiderCite y Microsoft Copilot) para apoyar la síntesis de evidencia vs. métodos de búsqueda tradicionales y establecer recomendaciones de implementación bajo un enfoque “fit for purpose”, es decir, utilizar cada herramienta solo para tareas específicas donde aporten valor. Se evaluaron siete proyectos completados en la agencia, aplicando búsquedas de referencia (método tradicional) frente a búsquedas con cada herramienta de IA. Se midieron sensibilidad/recall, número necesario a leer (NNR), tiempo de búsqueda y cribado, y contribuciones únicas de cada herramienta. Además, se recogió experiencias de los especialistas en información sobre usabilidad, limitaciones y sorpresas en el uso de los tres sistemas.
Resultados
Método / Herramienta
Sensibilidad promedio
Diferencias entre proyectos simples y complejos
NNR (número necesario a leer)
Tiempo de búsqueda
Observaciones principales
Métodos tradicionales
0.98 – 1 (casi perfecta)
Consistentemente alta en todos los proyectos
Más bajo que IA
2.88 h en promedio
Estándar de referencia, máxima fiabilidad
Lens.org
0.676
Simples: 0.816 Complejos: 0.6
Más alto que el estándar (98 vs 83)
Mayor tiempo (2.25 h, más que Copilot o SpiderCite)
Mejor de las IA, pero menos eficiente; útil en búsquedas simples y de autores
SpiderCite
0.23 – 0.26
Similar en simples y complejos
Variable (Cited by mejor que Citing)
~1.25 h
Muy baja sensibilidad, pero puede aportar referencias únicas en temas complejos; solo útil como complemento
Copilot
0.24 (muy variable: 0–0.91 según proyecto)
Simples: 0.41 Complejos: 0.15
Muy variable (mejor en simples, muy alto en complejos)
Más rápido (0.96 h promedio)
Dependiente de la calidad de los prompts; no sustituye estrategias, útil para sugerir palabras clave
Sensibilidad = proporción de estudios relevantes efectivamente recuperados. NNR = número necesario a leer; cuanto menor, mejor eficiencia de cribado.
Verde = mejor desempeño relativo. Amarillo = intermedio / aceptable. Rojo = débil. Naranja = muy variable según proyecto.
Discusión
Las herramientas de IA mostraron rendimiento variable e inconsistente, lo que implica que no pueden reemplazar las búsquedas profesionales estándar en revisiones sistemáticas.
Pueden generar falsa confianza en usuarios sin experiencia. Se requiere conocimiento experto en construcción de estrategias y en validación de resultados para corregir limitaciones.
Limitaciones del estudio: solo se evaluaron 7 proyectos y 3 herramientas, sin analizar combinaciones entre ellas
Recomendaciones de implementación
La CDA-AMC propuso un uso limitado y estratégico:
Lens.org: útil para revisiones con preguntas acotadas y técnicas (como dispositivos con una función o población bien definida) o para identificar rápidamente autores vinculados a un tema o indicación clínica cuando los métodos estándar no alcanzan.
SpiderCite: complemento para búsquedas de citas en proyectos complejos, siempre que se disponga de artículos semilla.
Copilot (u otros LLMs): apoyo en la generación de palabras clave y términos de búsqueda, pero no para estrategias completas
Conclusión
Las tres herramientas evaluadas (Lens.org, SpiderCite, Copilot) no son adecuadas para reemplazar estrategias de búsqueda complejas en revisiones sistemáticas, debido a variabilidad en sensibilidad y precisión. Sin embargo, tienen potencial como apoyos puntuales en tareas específicas: generación de términos, búsquedas simples o de citas, y exploración preliminar. El estudio subraya la necesidad de mantener el papel central del bibliotecario/experto en información en la validación de cualquier resultado generado con IA, y de continuar monitorizando nuevas herramientas dada la rápida evolución tecnológica.
Reflexiones para quienes trabajamos en bibliotecas médicas
Las herramientas de IA pueden ahorrar tiempo en fases preliminares, generar ideas de términos de búsqueda, identificar autores, pero no deben utilizarse como única estrategia para revisiones sistemáticas si se espera exhaustividad.
Es clave entender los límites: sensibilidad menor, posible sesgo en lo que captura IA, variabilidad según prompt o según lo cerrado o amplio que sea el tema.
Siempre debe haber validación humana experta, verificación de resultados únicos que aparezcan en IA, comparación con lo recuperado por métodos tradicionales.